


Dlaczego istotność statystyczna jest ważna?
Dowiedz się, dlaczego istotność statystyczna ma znaczenie w analizie danych, badaniach naukowych i podejmowaniu decyzji biznesowych. Poznaj wartości p, testowan...
9 min czytania
Istotność statystyczna to prawdopodobieństwo, że związek między dwiema lub więcej zmiennymi jest spowodowany czymś innym niż przypadek.
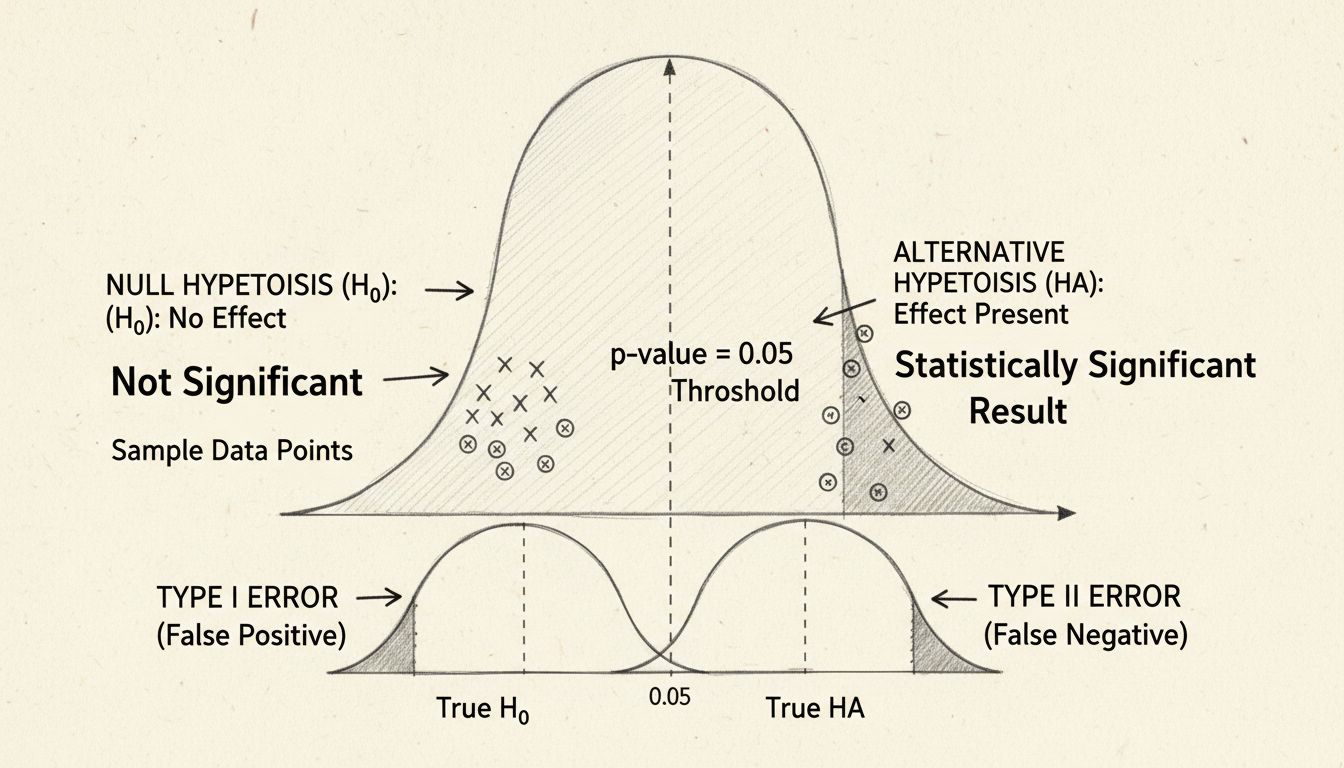
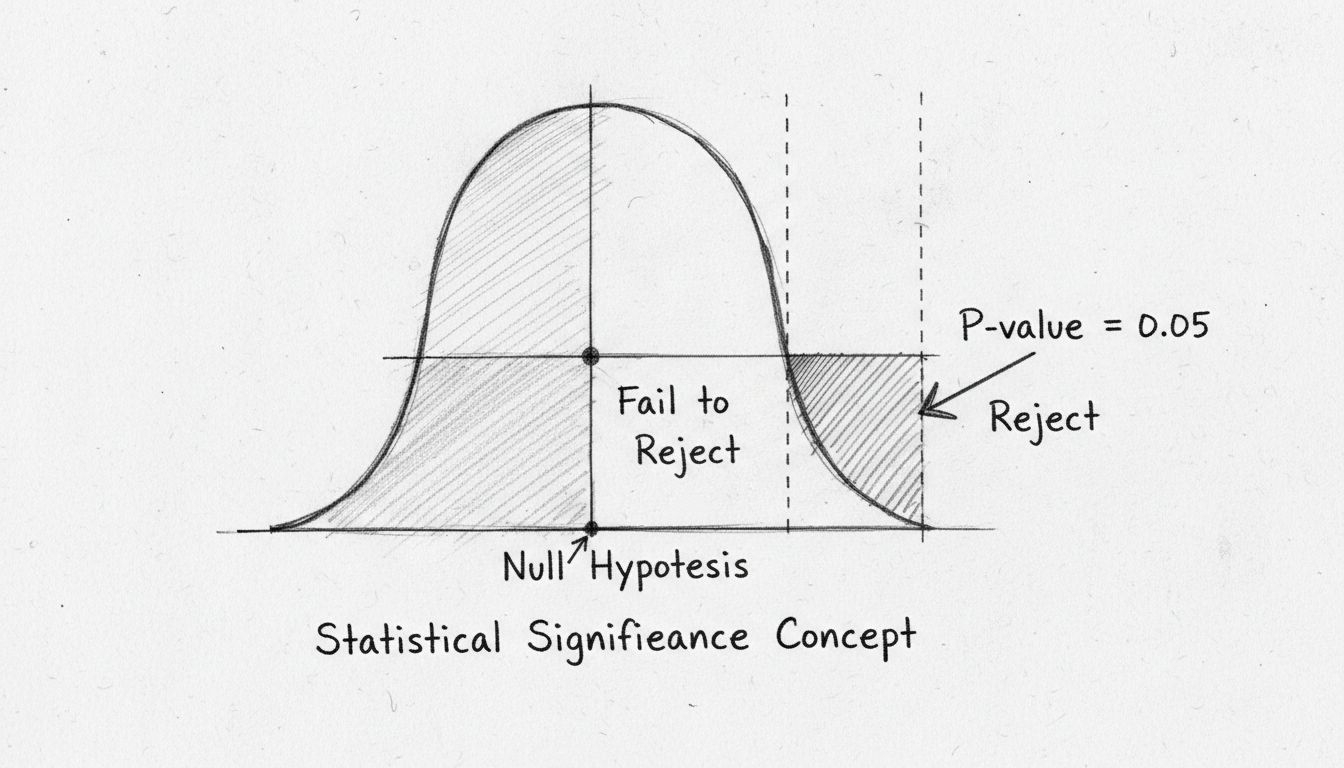
Istotność statystyczna to prawdopodobieństwo, że związek między dwiema lub więcej zmiennymi jest spowodowany czymś innym niż przypadek. W formalnym ujęciu jest to prawdopodobieństwo, że zaobserwowana różnica — lub bardziej skrajna — wystąpiłaby, gdyby hipoteza zerowa (założenie braku rzeczywistego efektu) była prawdziwa.
Każdy zbiór danych zawiera zmienność losową — naturalne fluktuacje występujące nawet wtedy, gdy nie ma żadnego rzeczywistego efektu. Rzuć uczciwą monetą 100 razy, a rzadko otrzymasz dokładnie 50 orłów. To odchylenie to szum losowy, a nie dowód na to, że moneta jest obciążona.
Istotność statystyczna określa ilościowo, czy odchylenie, które widzisz, jest wystarczająco duże w stosunku do wielkości próby, aby było mało prawdopodobne przy samym szumie losowym. Jeśli tak, możesz odrzucić hipotezę zerową i stwierdzić, że prawdopodobnie istnieje rzeczywisty efekt.
Dwa powiązane pojęcia pomagają to zrozumieć:
Załóżmy, że prowadzisz sklep internetowy i testujesz dwie wersje strony produktu. Wersja A konwertuje na poziomie 4,2%. Wersja B konwertuje na poziomie 4,8%. To różnica 0,6 punktu procentowego — ale czy jest rzeczywista?
Jeśli wartość p wynosiłaby 0,30, ta sama różnica byłaby w pełni zgodna z przypadkiem — a działanie na jej podstawie byłoby przedwczesne.

Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
Każdy test istotności zaczyna się od dwóch konkurencyjnych stwierdzeń:
Częste błędne interpretacje, których należy unikać:
Poziom istotności, oznaczany α (alfa), to próg ustalany przed rozpoczęciem testu. Reprezentuje Twoją tolerancję na fałszywie pozytywne wyniki — odrzucenie hipotezy zerowej, gdy w rzeczywistości jest prawdziwa. Nazywa się to również błędem I rodzaju.
| Próg | Znaczenie | Ryzyko fałszywie pozytywnego wyniku |
|---|---|---|
| α = 0,05 | Standard w większości dziedzin | 5% (1 na 20) |
| α = 0,01 | Bardziej rygorystyczny; stosowany, gdy fałszywie pozytywne wyniki są kosztowne | 1% (1 na 100) |
| α = 0,001 | Bardzo rygorystyczny; decyzje wysokiej stawki | 0,1% (1 na 1000) |
Jeśli p < α, wynik jest istotny statystycznie na tym poziomie.
Przedział ufności podaje zakres prawdopodobnych wartości rzeczywistej wielkości efektu. 95% przedział ufności oznacza: jeśli powtórzysz badanie 100 razy, około 95 z tych przedziałów będzie zawierać prawdziwą wartość.
Węższe przedziały wskazują na bardziej precyzyjne oszacowania — zazwyczaj wynikają z większych prób. W kontekście biznesowym przedziały ufności są często bardziej informacyjne niż same wartości p, ponieważ pokazują wielkość i kierunek efektu, a nie tylko to, czy istnieje.
Tak — w większości dziedzin stosowanych p < 0,05 jest standardem do stwierdzania istotności statystycznej. Konwencja ta wywodzi się z prac Ronalda Fishera z lat 20. XX wieku i choć jest nieco arbitralna, utrzymała się, ponieważ równoważy dwa ryzyka: fałszywie pozytywne wyniki (błędy I rodzaju) i fałszywie negatywne wyniki (błędy II rodzaju, gdy rzeczywisty efekt zostaje pominięty).
Wartość p 0,01 jest bardziej istotna statystycznie niż 0,05, ponieważ wskazuje na mniejsze prawdopodobieństwo, że zaobserwowany wynik wynika z przypadku. Przy α = 0,01 akceptujesz tylko 1% ryzyka fałszywie pozytywnego wyniku, w porównaniu z 5% przy α = 0,05.
Jednak niższa wartość p nie oznacza automatycznie większego lub ważniejszego efektu. Przy ogromnej próbie nawet trywialnie mała różnica może dać p < 0,001. Dlatego wielkość efektu i istotność praktyczna muszą być oceniane razem z wartością p.
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
Wielkość próby jest najważniejszym czynnikiem. Większe próby zmniejszają wpływ zmienności losowej, ułatwiając wykrycie prawdziwych różnic. Dlatego wzrost konwersji o 2% może być istotny przy 50 000 odwiedzających, ale nie przy 500.
Wielkość efektu mierzy wielkość zaobserwowanej różnicy — nie tylko to, czy istnieje. Duża wielkość efektu (np. 30% wzrost konwersji) osiąga istotność szybciej i przy mniejszych próbach. Niewielka wielkość efektu (np. 0,5%) wymaga ogromnych prób, aby zostać wiarygodnie wykryta.
Tutaj kluczowy staje się związek między istotnością statystyczną a istotnością praktyczną. Wynik może być istotny statystycznie, ale praktycznie nieistotny, jeśli efekt jest zbyt mały, by miał znaczenie dla decyzji biznesowych.
Żaden test statystyczny nie zrekompensuje złych danych. Typowe problemy z jakością danych obejmują:
Przed obliczeniem istotności statystycznej upewnij się, że zbieranie danych jest czyste, spójne i wolne od systematycznych obciążeń. Istotny wynik z wadliwych danych jest gorszy niż brak wyniku.
Moc zależy od wielkości próby, wielkości efektu i wybranego poziomu istotności. Badania o zbyt niskiej mocy to częsty powód, dla którego pozornie obiecujące wyniki testów A/B nie udaje się powtórzyć.
Istotność statystyczna to prawdopodobieństwo, że związek między dwiema lub więcej zmiennymi jest spowodowany czymś innym niż przypadek. W formalnym ujęciu jest to prawdopodobieństwo, że zaobserwowana różnica — lub bardziej skrajna — wystąpiłaby, gdyby hipoteza zerowa (założenie braku rzeczywistego efektu) była prawdziwa.
Podstawą jest testowanie hipotez, gałąź analizy statystycznej rozwinięta na początku XX wieku przez Ronalda Fishera, a następnie udoskonalona przez Jerzego Neymana i Egona Pearsona.
Każdy zbiór danych zawiera zmienność losową — naturalne fluktuacje występujące nawet wtedy, gdy nie ma żadnego rzeczywistego efektu. Rzuć uczciwą monetą 100 razy, a rzadko otrzymasz dokładnie 50 orłów. To odchylenie to szum losowy, a nie dowód na to, że moneta jest obciążona.
Istotność statystyczna określa ilościowo, czy odchylenie, które widzisz, jest wystarczająco duże w stosunku do wielkości próby, aby było mało prawdopodobne przy samym szumie losowym. Jeśli tak, możesz odrzucić hipotezę zerową i stwierdzić, że prawdopodobnie istnieje rzeczywisty efekt.
Dwa powiązane pojęcia pomagają to zrozumieć:
Załóżmy, że prowadzisz sklep internetowy i testujesz dwie wersje strony produktu. Wersja A konwertuje na poziomie 4,2%. Wersja B konwertuje na poziomie 4,8%. To różnica 0,6 punktu procentowego — ale czy jest rzeczywista?
Przeprowadzasz test statystyczny. Zwraca wartość p 0,03.
Jeśli wartość p wynosiłaby 0,30, ta sama różnica byłaby w pełni zgodna z przypadkiem — a działanie na jej podstawie byłoby przedwczesne.
Każdy test istotności zaczyna się od dwóch konkurencyjnych stwierdzeń:
Test nie dowodzi bezpośrednio H₁.
Ta struktura ma bezpośrednie zastosowanie w testach A/B.
Częste błędne interpretacje, których należy unikać:
Poziom istotności, oznaczany α (alfa), to próg ustalany przed rozpoczęciem testu. Reprezentuje Twoją tolerancję na fałszywie pozytywne wyniki — odrzucenie hipotezy zerowej, gdy w rzeczywistości jest prawdziwa. Nazywa się to również błędem I rodzaju.
| Próg | Znaczenie | Ryzyko fałszywie pozytywnego wyniku |
|---|---|---|
| α = 0,05 | Standard w większości dziedzin | — |
| α = 0,01 | Bardziej rygorystyczny; stosowany, gdy fałszywie pozytywne wyniki są kosztowne | — |
| α = 0,001 | Bardzo rygorystyczny; decyzje wysokiej stawki | — |
Jeśli p < α, wynik jest istotny statystycznie na tym poziomie.
Przedział ufności podaje zakres prawdopodobnych wartości rzeczywistej wielkości efektu. 95% przedział ufności oznacza: jeśli powtórzysz badanie 100 razy, około 95 z tych przedziałów będzie zawierać prawdziwą wartość.
Węższe przedziały wskazują na bardziej precyzyjne oszacowania — zazwyczaj wynikają z większych prób. W kontekście biznesowym przedziały ufności są często bardziej informacyjne niż same wartości p, ponieważ pokazują wielkość i kierunek efektu, a nie tylko to, czy istnieje.
Tak — w większości dziedzin stosowanych p < 0,05 jest standardem do stwierdzania istotności statystycznej. Konwencja ta wywodzi się z prac Ronalda Fishera z lat 20. XX wieku i choć jest nieco arbitralna, utrzymała się, ponieważ równoważy dwa ryzyka: fałszywie pozytywne wyniki (błędy I rodzaju) i fałszywie negatywne wyniki (błędy II rodzaju, gdy rzeczywisty efekt zostaje pominięty).
Wartość p 0,01 jest bardziej istotna statystycznie niż 0,05, ponieważ wskazuje na mniejsze prawdopodobieństwo, że zaobserwowany wynik wynika z przypadku. Przy α = 0,01 akceptujesz tylko 1% ryzyka fałszywie pozytywnego wyniku, w porównaniu z 5% przy α = 0,05.
Jednak niższa wartość p nie oznacza automatycznie większego lub ważniejszego efektu. Przy ogromnej próbie nawet trywialnie mała różnica może dać p < 0,001. Dlatego wielkość efektu i istotność praktyczna muszą być oceniane razem z wartością p.
Wartość p poniżej 0,001 oznacza, że zaobserwowany wynik wystąpiłby przez przypadek rzadziej niż 1 na 1000 razy, gdyby hipoteza zerowa była prawdziwa. To silny dowód przeciwko hipotezie zerowej — ale wciąż nie gwarantuje praktycznego znaczenia.
Wielkość próby jest najważniejszym czynnikiem. Większe próby zmniejszają wpływ zmienności losowej, ułatwiając wykrycie prawdziwych różnic. Dlatego wzrost konwersji o 2% może być istotny przy 50 000 odwiedzających, ale nie przy 500.
W przypadku stron o niskim ruchu oznacza to, że testy muszą trwać dłużej lub celować w zmiany o większym efekcie.
Wielkość efektu mierzy wielkość zaobserwowanej różnicy — nie tylko to, czy istnieje. Duża wielkość efektu (np. 30% wzrost konwersji) osiąga istotność szybciej i przy mniejszych próbach. Niewielka wielkość efektu (np. 0,5%) wymaga ogromnych prób, aby zostać wiarygodnie wykryta.
Tutaj kluczowy staje się związek między istotnością statystyczną a istotnością praktyczną. Wynik może być istotny statystycznie, ale praktycznie nieistotny, jeśli efekt jest zbyt mały, by miał znaczenie dla decyzji biznesowych.
Żaden test statystyczny nie zrekompensuje złych danych. Typowe problemy z jakością danych obejmują:
Przed obliczeniem istotności statystycznej upewnij się, że zbieranie danych jest czyste, spójne i wolne od systematycznych obciążeń. Istotny wynik z wadliwych danych jest gorszy niż brak wyniku.
Moc statystyczna to prawdopodobieństwo, że test wykryje rzeczywisty efekt, gdy ten istnieje. Jest dopełnieniem wskaźnika błędu II rodzaju (β).
Moc zależy od wielkości próby, wielkości efektu i wybranego poziomu istotności. Badania o zbyt niskiej mocy to częsty powód, dla którego pozornie obiecujące wyniki testów A/B nie udaje się powtórzyć.
Różne typy danych wymagają różnych testów:
| Test | Zastosowanie | Przykład |
|---|---|---|
| Test t | Porównanie średnich dwóch grup | Współczynniki konwersji: wersja A vs. wersja B |
| Test chi-kwadrat | Porównanie częstości kategorycznych | Współczynniki klikalności dla wielu kreacji reklamowych |
| Test Z | Porównanie proporcji przy dużych próbach | Proporcje konwersji na stronach docelowych |
| ANOVA | Porównanie średnich w trzech lub więcej grupach | Wyniki wielu partnerów afiliacyjnych |
Nie musisz obliczać istotności statystycznej ręcznie. Powszechnie używane narzędzia to:
Większość narzędzi podaje zarówno wartość p, jak i przedział ufności. Zawsze sprawdzaj obie te wartości przed podjęciem decyzji.
Istotność statystyczna to nie tylko koncepcja akademicka. W marketingu afiliacyjnym, gdzie prowizje, budżety i relacje z partnerami zależą od danych dotyczących wyników, jest to praktyczne zabezpieczenie przed kosztownymi błędami w ocenie.
Reklamodawcy prowadzący programy afiliacyjne rutynowo testują strony docelowe, struktury ofert i materiały kreatywne. Istotność statystyczna zapewnia, że decyzje o tym, którą wersję rozwijać, opierają się na rzeczywistych różnicach w wynikach, a nie na przypadkowych fluktuacjach.
Przykładowy przepływ pracy: Reklamodawca testuje dwie struktury prowizji — stałą stawkę 10% vs. model warstwowy 5%/12%/18%. Po 30 dniach i 5000 transakcji model warstwowy wykazuje o 22% wyższą średnią wartość zamówienia. Test t zwraca p = 0,02. Reklamodawca może z pewnością wdrożyć strukturę warstwową, wiedząc, że zaobserwowana różnica raczej nie jest przypadkowym szumem.
Bez testowania istotności reklamodawca mógłby wprowadzić zmianę na podstawie krótkoterminowych wahań — i potencjalnie obniżyć zarobki partnerów, gdyby efekt się odwrócił.
Wydawcy (afilianci) podejmują decyzje o tym, które produkty promować, w które źródła ruchu inwestować i które formaty treści najlepiej konwertują. Każda z tych decyzji korzysta z testowania istotności.
Przykładowy przepływ pracy: Wydawca testuje dwie wersje artykułu recenzyjnego — jedną z tabelą porównawczą na górze, drugą z tabelą na dole. Po 10 000 wyświetleń stronic, wersja z tabelą u góry generuje 3,1% współczynnika klikalności do sprzedawcy, w porównaniu z 2,6% dla wersji z tabelą na dole. Test chi-kwadrat daje p = 0,04. Wydawca przyjmuje format z tabelą u góry i stosuje ten wzór w innych recenzjach.
Menedżerowie programów oceniają wyniki partnerów, ustalają poziomy prowizji i decydują, których afiliantów rekrutować lub zatrzymywać. Istotność statystyczna pomaga odróżnić konsekwentnie dobrze radzących sobie partnerów od tych, których dobre miesiące to tylko przypadkowa zmienność.
Przykładowy przepływ pracy: Menedżer programu porównuje dwóch afiliantów o podobnym wolumenie ruchu. Afiliant A ma 5,2% współczynnik konwersji przez 12 miesięcy; Afiliant B ma 4,1%. Dwuwagowy test Z potwierdza, że różnica jest istotna (p = 0,008). Menedżer wykorzystuje te dane do przyznania wyższych prowizji Afiliantowi A i zbadania, co Afiliant B może poprawić.
We wszystkich trzech rolach obowiązuje ta sama zasada: poczekaj, aż dane osiągną istotność, zanim podejmiesz działanie. Przedwczesne decyzje — podnoszenie prowizji partnerowi, który miał jeden dobry miesiąc, lub porzucenie strony docelowej po jednym złym tygodniu — należą do najczęstszych i najbardziej możliwych do uniknięcia błędów w marketingu afiliacyjnym.
To najbardziej uporczywe nieporozumienie. Wynik może być istotny statystycznie przy p < 0,001 i wciąż być zbyt mały, by miał znaczenie. W jednym z dobrze znanych przykładów z podręcznika inżynierii statystycznej NIST, ulepszenie procesu produkcyjnego było istotne statystycznie, ale przyniosło zysk zaledwie 0,2 jednostki — daleko poniżej progu praktycznej wartości.
Zawsze zadawaj dwa pytania:
P-hacking odnosi się do praktyki przeprowadzania wielu analiz i selektywnego raportowania tylko tych, które osiągają istotność. Typowe formy obejmują:
Praktyki te drastycznie zwiększają wskaźnik fałszywie pozytywnych wyników.
Wniosek dla użytkowników biznesowych: zarejestruj wcześniej swój plan testu, trzymaj się jednej głównej metryki i opieraj się pokusie „łowienia" istotności.
Istotność statystyczna jest mniej przydatna — lub wręcz myląca — w następujących scenariuszach:
Wykorzystaj istotność statystyczną, aby optymalizować kampanie, poprawiać współczynniki konwersji i podejmować mądrzejsze decyzje marketingowe.
Dowiedz się, dlaczego istotność statystyczna ma znaczenie w analizie danych, badaniach naukowych i podejmowaniu decyzji biznesowych. Poznaj wartości p, testowan...
Dowiedz się, jak istotność statystyczna pozwala określić, czy wyniki są rzeczywiste, czy przypadkowe. Poznaj p-wartości, testowanie hipotez i praktyczne zastoso...

Opanuj istotność statystyczną w testach A/B dla kampanii afiliacyjnych w branży bukmacherskiej.
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.


Zgoda na Pliki Cookie
Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our privacy policy.