


Jak naprawić problemy z duplikacją treści: Kompletny przewodnik SEO
Poznaj sprawdzone metody naprawy problemów z duplikacją treści, w tym przekierowania 301, tagi kanoniczne i dyrektywy noindex. Chroń swoje pozycje SEO dzięki ek...
11 min czytania
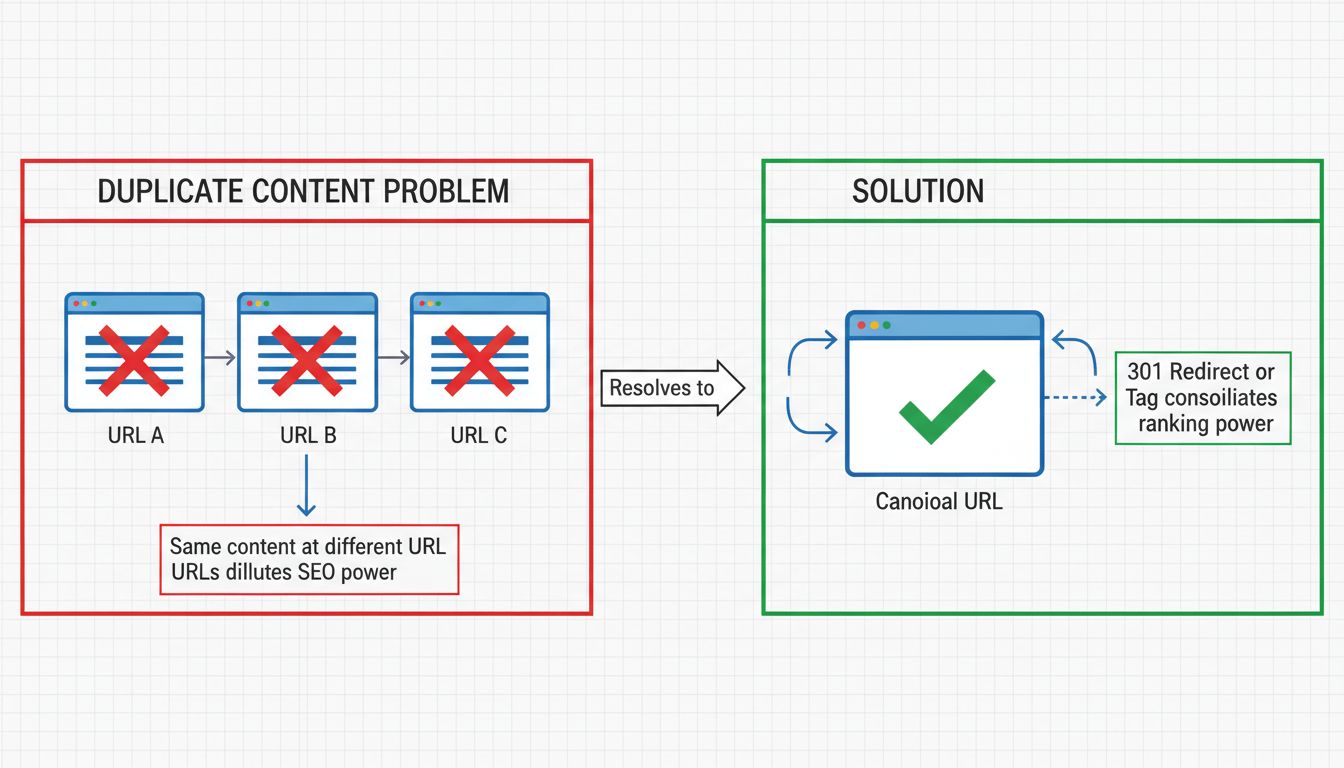
Duplikacja treści to znaczące bloki tekstu, kodu lub multimediów, które pojawiają się w więcej niż jednym miejscu w internecie — co oznacza, że dwa lub więcej różnych adresów URL dostarcza użytkownikom i wyszukiwarkom ten sam lub bardzo podobny materiał.
Duplikacja treści to znaczące bloki tekstu, kodu lub multimediów, które pojawiają się w więcej niż jednym miejscu w internecie — co oznacza, że dwa lub więcej różnych adresów URL dostarcza użytkownikom i wyszukiwarkom ten sam lub bardzo podobny materiał. Gdy Google, Bing lub inna wyszukiwarka napotka tę samą treść pod wieloma adresami URL, musi zdecydować, którą wersję zaindeksować, którą pozycjonować, a którą zignorować. Ta decyzja nie zawsze jest taka, jaką sam byś podjął.
Zrozumienie duplikacji treści ma znaczenie dla każdego, kto prowadzi stronę internetową, zarządza programem afiliacyjnym lub publikuje treści online. Pozostawiona bez kontroli rozdziela sygnały rankingowe, marnuje budżet indeksowania i dezorientuje wyszukiwarki, od których zależy Twój ruch.
Na tej stronie
Duplikacja treści oznacza, że ta sama lub bardzo podobna treść znajduje się pod więcej niż jednym adresem URL. Te adresy URL mogą należeć do tej samej domeny (duplikacja wewnętrzna) lub do zupełnie różnych stron internetowych (duplikacja zewnętrzna).
Strona kwalifikuje się jako duplikat, gdy wykazuje zauważalne podobieństwo w sformułowaniach, strukturze i głównym przekazie z inną stroną, dodaje niewiele lub wcale oryginalnych informacji i nie oferuje znaczącej wartości poza tym, co już zapewnia inna wersja. Nagłówki, stopki i elementy nawigacyjne powtarzające się na stronie nie liczą się — wyszukiwarki rozumieją, że są one częścią szablonu, a nie samej treści.
Duplikacja wewnętrzna występuje w obrębie jednej domeny. Typowe scenariusze obejmują:
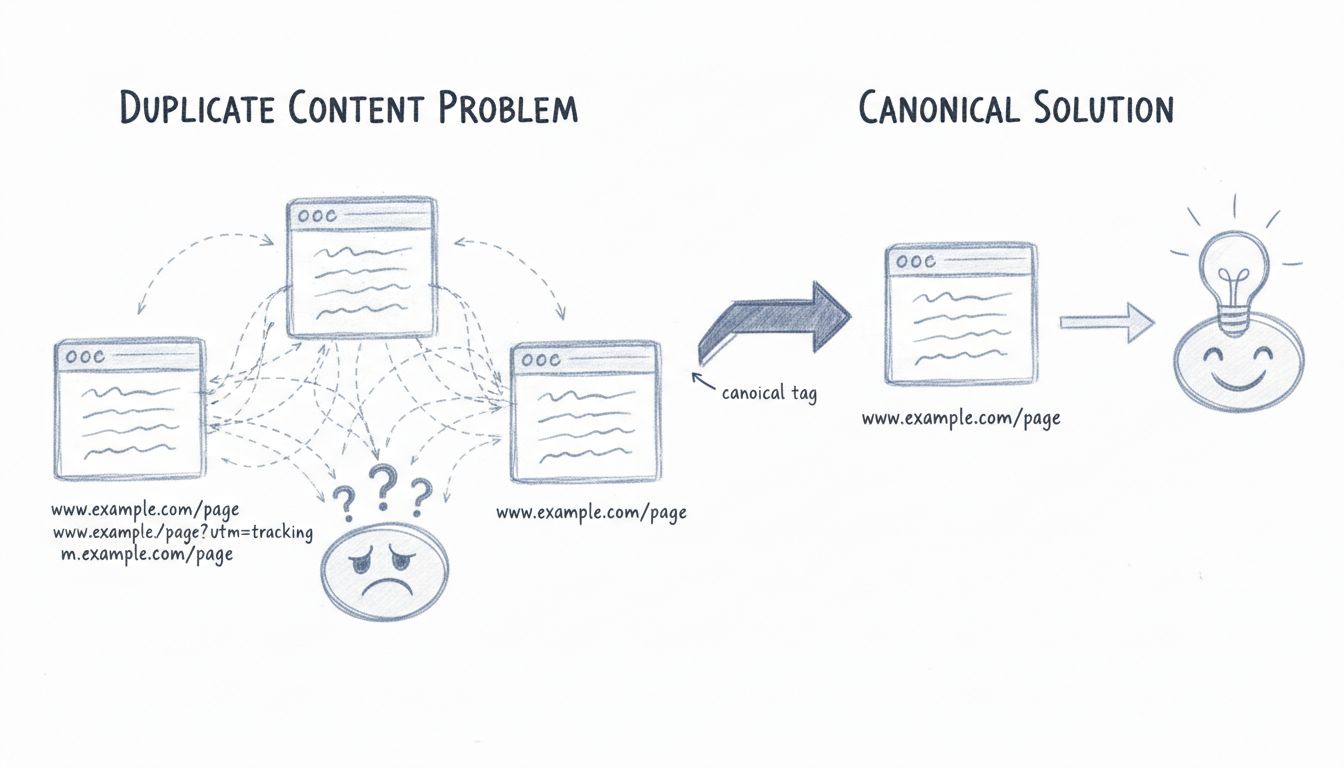
example.com/product, jak i example.com/product?color=blueKażdy z tych przypadków tworzy osobny adres dla tej samej treści. Wyszukiwarki widzą wiele adresów URL konkurujących o to samo zapytanie i rzadko nagradzają je wszystkie.
Duplikacja zewnętrzna występuje, gdy treść z jednej domeny pojawia się na innej. Może to być działanie złośliwe — treści scrapowane i publikowane ponownie bez zgody — lub całkowicie legalne, jak w przypadku artykułów syndykowanych dystrybuowanych do stron partnerskich. Bez znacznika kanonicznego wskazującego oryginał, wyszukiwarki mogą wyświetlać kopię wyżej niż źródło lub dzielić sygnały rankingowe między obie wersje.
Nie wszystkie zduplikowane treści są identyczne. Prawie duplikacja treści ma tę samą strukturę i główny przekaz, ale różni się drobnymi szczegółami: strona produktu, gdzie zmienia się tylko nazwa koloru, strona dotycząca obszaru usług, gdzie różni się tylko miasto, lub przetłumaczona wersja tego samego artykułu. Google traktuje je jako duplikaty, gdy różnice są zbyt małe, aby uzasadnić osobną stronę. Próg nie jest ustalonym procentem — chodzi o to, czy każda strona zapewnia rzeczywiście odrębną wartość dla użytkownika.

Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
Duplikacja treści powoduje trzy konkretne problemy zarówno dla wyszukiwarek, jak i właścicieli stron.
Gdy wiele adresów URL dostarcza tę samą treść, wyszukiwarki muszą wybrać jedną do przechowywania w swoim indeksie. Mogą wybrać niewłaściwą — niezoptymalizowany adres URL z wieloma parametrami zamiast czystej wersji kanonicznej. Pozostałe wersje mogą zostać całkowicie pominięte, co oznacza, że strona, którą chcesz pozycjonować, nigdy nie pojawi się w wynikach wyszukiwania.
Linki zwrotne należą do najsilniejszych sygnałów rankingowych. Gdy zewnętrzne strony linkują do różnych wersji tej samej treści — niektóre do wersji HTTP, inne do HTTPS, jeszcze inne z końcowym ukośnikiem lub bez — autorytet, jaki niosą te linki, jest rozdzielany na wiele adresów URL zamiast koncentrować się na jednym. Strona, która mogłaby zajmować trzecią pozycję, może znaleźć się na dwunastej, ponieważ jej wartość linków jest rozproszona na cztery zduplikowane adresy URL.
Wyszukiwarki przeznaczają ograniczoną ilość czasu i zasobów na indeksowanie każdej strony. Każdy zduplikowany adres URL przetwarzany przez robota indeksującego to o jedną mniej unikalną, wartościową stronę, którą może on odkryć i zaindeksować w trakcie danej sesji. Na dużych stronach — sklepach e-commerce z tysiącami SKU, hubach treści afiliacyjnych z dynamicznie generowanymi stronami — marnowanie budżetu indeksowania z powodu duplikatów może ograniczyć widoczność naprawdę ważnych stron.
Nie — w sensie ręcznej kary. Większość duplikacji treści w internecie jest przypadkowa, a nie wprowadzająca w błąd, a systemy Google biorą to pod uwagę.
Rozróżnienie ma znaczenie. Google podejmuje działania przeciwko celowo manipulacyjnej duplikacji: stronom, które scrapują i publikują ponownie treści na masową skalę wyłącznie w celu przyciągnięcia ruchu z wyszukiwarek, lub które generują tysiące prawie identycznych stron przejściowych (doorway pages) wypełnionych słowami kluczowymi. W takich przypadkach Google może zastosować działanie ręczne lub algorytmiczne tłumienie. Ale dla zwykłego właściciela strony z kilkoma zduplikowanymi adresami URL wynikającymi z parametrów, konsekwencją nie jest kara — to utracona szansa z powodu rozproszonych sygnałów i rozwodnionych pozycji.
Praktyczny efekt jest podobny: Twoje treści osiągają gorsze wyniki. Zrozumienie jednak, że jest to efekt filtrowania algorytmicznego, a nie kara, pomaga prawidłowo ustalić priorytety napraw. Nie ścigasz się, aby uniknąć kary — konsolidujesz siłę, która już jest Twoja.
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
Większość duplikacji treści jest tworzona przypadkowo, w wyniku domyślnego działania systemów zarządzania treścią, platform e-commerce i architektur stron.
Parametry śledzące (?utm_source=, ?session_id=), opcje sortowania (?sort=cena) i kombinacje filtrów generują unikalne adresy URL dla w zasadzie tej samej strony. Pojedyncza strona produktu w sklepie e-commerce może wygenerować dziesiątki sparametryzowanych adresów URL, z których każdy jest indeksowany osobno, jeśli nie jest odpowiednio zarządzany.
Jeśli Twoja strona jest dostępna zarówno pod adresem http://example.com, jak i https://example.com, lub zarówno pod https://www.example.com, jak i https://example.com, masz co najmniej dwie wersje każdej strony. Bez przekierowania ogólnostronowego z jednej na drugą, obie wersje mogą być indeksowane.
example.com/strona i example.com/strona/ mogą wyświetlać tę samą treść, ale rejestrować się jako różne adresy URL. Większość nowoczesnych systemów CMS radzi sobie z tym automatycznie, ale nieprawidłowo skonfigurowane serwery mogą udostępniać obie wersje.
Osobne adresy URL dla wersji artykułów zoptymalizowanych do druku lub AMP tworzą duplikaty głównej treści. Jeśli te alternatywne wersje są indeksowalne, konkurują z oryginałem.
Gdy inne strony kopiują Twoje treści — z pozwoleniem lub bez — tworzą zewnętrzne duplikaty. Nawet legalni partnerzy syndykacyjni potrzebują znaczników kanonicznych wskazujących na Twój oryginał; w przeciwnym razie ich opublikowana wersja może przewyższać Twoją w wynikach wyszukiwania.
Producenci często dostarczają ten sam opis produktu setkom sprzedawców i afiliantów. Gdy każdy sprzedawca publikuje ten identyczny tekst, wyszukiwarki widzą masową duplikację w obrębie wielu domen.
Strony e-commerce i katalogowe, które pozwalają użytkownikom filtrować według rozmiaru, koloru, zakresu cenowego lub oceny, tworzą kombinatoryczną eksplozję adresów URL. Strona kategorii z pięcioma opcjami filtrowania, każda z pięcioma wartościami, może wygenerować ponad 3000 unikalnych adresów URL — wszystkie wyświetlające w zasadzie tę samą siatkę produktów.
Strony testowe przypadkowo pozostawione jako indeksowalne tworzą duplikację całej strony produkcyjnej. Błędna konfiguracja robots.txt lub brak znacznika noindex na serwerze deweloperskim może spowodować, że cała strona zostanie zduplikowana w wynikach wyszukiwania.
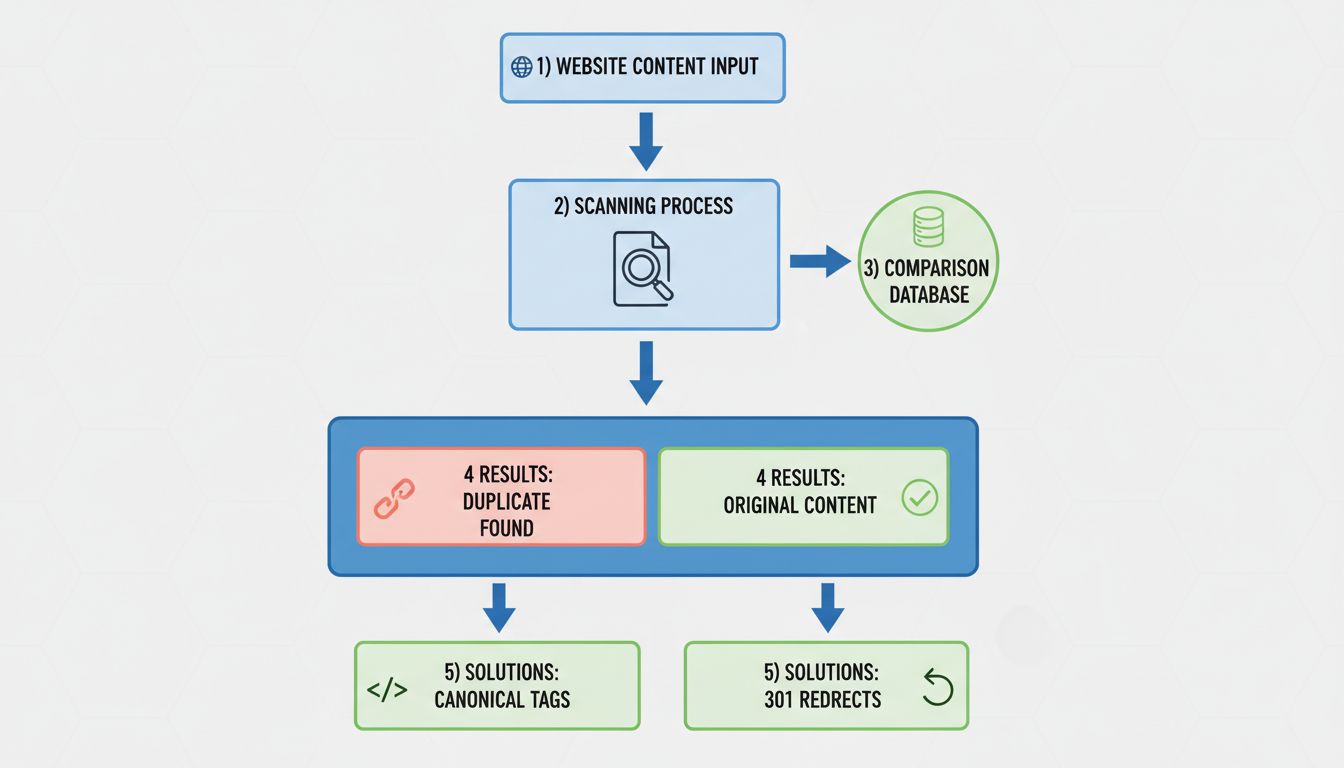
Zanim naprawisz duplikację treści, musisz wiedzieć, gdzie się znajduje. Kilka metod i narzędzi ułatwia to zadanie.
To najszybszy i najbardziej autorytatywny sposób na wykrycie duplikacji, która już wpływa na Twoje pozycje.
Dedykowane narzędzia SEO do indeksowania — Screaming Frog, Sitebulb, Ahrefs Site Audit, Semrush Site Audit — indeksują całą Twoją stronę i oznaczają strony z duplikatami tytułów, duplikatami meta opisów i prawie identyczną treścią. Raport Screaming Frog “Duplicate Pages” grupuje adresy URL według skrótu treści i pokazuje dokładnie, które strony mają tę samą lub prawie identyczną treść. Większość tych narzędzi oferuje darmowe wersje wystarczające dla małych i średnich stron.
Skopiuj charakterystyczne zdanie ze swojej treści — umieszczone w cudzysłowie — i wklej je do Google. Wyniki pokażą każdą zaindeksowaną stronę zawierającą to dokładne wyrażenie. Jeśli zobaczysz adresy URL, których się nie spodziewałeś, znalazłeś zewnętrzne duplikaty lub wewnętrzne strony, o których nie wiedziałeś, że są indeksowane.
Narzędzia takie jak Copyscape i Siteliner porównują Twoje treści z całym internetem oraz z innymi stronami w Twojej domenie. Copyscape jest szczególnie przydatny do znajdowania stron, które scrapowały Twoje treści bez pozwolenia. Siteliner skanuje odsetek wewnętrznych duplikacji w Twojej domenie.
Sprawdź, czy Twoja strona jest dostępna pod wieloma wariantami protokołu i subdomeny. Otwórz http://twojastrona.pl, https://twojastrona.pl, http://www.twojastrona.pl i https://www.twojastrona.pl. Jeśli więcej niż jeden prowadzi do aktywnej strony zamiast przekierowania, masz systemowy problem z duplikacją treści, który dotyczy każdej strony.
Naprawa duplikacji treści oznacza poinformowanie wyszukiwarek, która wersja strony ma być wyświetlana w wynikach i skonsolidowanie wszystkich sygnałów za nią.
Przekierowanie 301 trwale kieruje użytkowników i wyszukiwarki ze zduplikowanego adresu URL do wersji kanonicznej. To najsilniejszy sygnał, jaki możesz wysłać: konsoliduje wartość linków, usuwa duplikat z indeksu z czasem i zapewnia, że odwiedzający zawsze trafiają na właściwą stronę.
Użyj przekierowań 301, gdy:
<link rel="canonical" href="https://example.com/original-page/" />
Znaczniki kanoniczne są odpowiednim narzędziem, gdy:
W przeciwieństwie do przekierowania, znacznik kanoniczny nie usuwa zduplikowanego adresu URL — jedynie sygnalizuje preferencję. Wyszukiwarki traktują go jako silną wskazówkę, a nie bezwzględne polecenie.
Znacznik noindex instruuje wyszukiwarki, aby nie uwzględniały strony w indeksie. Używaj go na stronach, które służą użytkownikom, ale nigdy nie powinny pojawiać się w wynikach wyszukiwania: strony podziękowań, wewnętrzne strony wyników wyszukiwania, wersje do druku i środowiska testowe.
<meta name="robots" content="noindex" />
Połącz noindex z follow, jeśli chcesz, aby wartość linków nadal przepływała przez stronę do innych miejsc docelowych.
Za każdym razem, gdy linkujesz do strony w swojej witrynie, używaj dokładnie tego samego formatu adresu URL. Jeśli Twoja wersja kanoniczna to https://example.com/strona/, nie linkuj do https://www.example.com/strona ani http://example.com/strona/ w swojej nawigacji, treści ani stopce. Niespójność we własnym linkowaniu wysyła mieszane sygnały, które podważają Twoje wybory kanoniczne.
Narzędzie URL Parameters w Google Search Console (w ramach Legacy Tools) pozwala poinformować Google, jak traktować określone parametry. Możesz określić, że ?sort= lub ?session_id= nie zmienia treści strony, co pomaga Google konsolidować sparametryzowane adresy URL pod wersją kanoniczną. Używaj tego ostrożnie — błędna konfiguracja może spowodować, że Google zignoruje parametry, które rzeczywiście generują znacząco różne treści.
Najtrwalszym rozwiązaniem problemu duplikacji treści jest tworzenie stron, które są naprawdę odrębne. Dla marketerów afiliacyjnych oznacza to pisanie oryginalnych recenzji produktów, porównań i przewodników zamiast publikowania opisów producenta. Dla sklepów e-commerce oznacza to dodawanie unikalnych zdjęć produktów, sekcji pytań i odpowiedzi klientów oraz oryginalnych przewodników zakupowych. Wyszukiwarki nagradzają treści, które dodają wartość poza tym, co już istnieje gdzie indziej.
Marketerzy afiliacyjni stają przed wyjątkowym wyzwaniem związanym z duplikacją treści: promują produkty, które setki lub tysiące innych afiliantów również promuje, często używając tych samych opisów, zdjęć i specyfikacji dostarczonych przez producenta.
Gdy afiliant kopiuje opis produktu ze strony sprzedawcy i publikuje go dosłownie, dołącza do puli identycznych stron konkurujących o te same słowa kluczowe. Google widzi dziesiątki lub setki stron z tym samym tekstem i musi wybrać jedną — lub żadną — do wyświetlenia. Strona produktu samego sprzedawcy, z wyższym autorytetem domeny, prawie zawsze wygrywa. Strona afilianta spada w wynikach.
To nie jest kara. To problem trafności i autorytetu: identyczna treść nie wnosi nic nowego do internetu, więc wyszukiwarki nie mają powodu wyświetlać wielu jej kopii.
Pisz oryginalne recenzje produktów. Zamiast powtarzać listę funkcji producenta, opisz swoje praktyczne doświadczenia z produktem. Co Cię zaskoczyło? Co Cię frustrowało? Jak wypada w porównaniu z alternatywami, które testowałeś? Szczegóły z pierwszej ręki nie mogą być powielone przez nikogo innego.
Dodawaj unikalną wartość wykraczającą poza opis produktu. Dołącz oryginalne zdjęcia, nagrania wideo, samodzielnie przygotowane tabele porównawcze, scenariusze użycia i odpowiedzi na pytania, których strona producenta nie porusza.
Używaj znaczników kanonicznych podczas syndykacji. Jeśli publikujesz treści, które pojawiają się również na stronie sprzedawcy lub blogu partnerskim, dodaj znacznik kanoniczny wskazujący wersję, którą chcesz pozycjonować. Uzgodnij z menedżerem programu afiliacyjnego, który adres URL jest kanoniczny.
Unikaj strategii stron przejściowych (doorway pages). Tworzenie dziesiątek prawie identycznych stron celujących w niewielkie warianty słów kluczowych — niegdyś powszechna taktyka afiliacyjna — jest wyraźnie sprzeczne z wytycznymi Google i grozi algorytmicznym tłumieniem. Jedna kompleksowa strona dogłębnie traktująca temat osiągnie lepsze wyniki niż dziesięć cienkich wariantów.
Menedżerowie programów afiliacyjnych mogą zmniejszyć problemy z duplikacją treści w swojej sieci afiliacyjnej poprzez:
Sprzedawcy i reklamodawcy prowadzący programy afiliacyjne zyskują, gdy ich afilianci publikują unikalne, wysokiej jakości treści. Rozszerza to ślad wyszukiwania marki na większą liczbę słów kluczowych i zapytań, niż strona sprzedawcy mogłaby objąć samodzielnie. Duplikacja treści ze strony afiliantów, przeciwnie, nie dodaje żadnej dodatkowej obecności w wynikach wyszukiwania i może stworzyć negatywny wizerunek marki, gdy użytkownicy napotykają ten sam tekst na dziesiątkach niskiej jakości stron. Inwestycja w edukację afiliantów i unikalne materiały kreatywne przynosi bezpośrednie korzyści w zakresie SEO.
Nie ma oficjalnego progu procentowego, poniżej którego duplikacja treści jest “bezpieczna”. Google nie używa wskaźnika duplikacji, który uruchamia działanie przy określonym poziomie. Zamiast tego pytanie brzmi: czy każda strona zapewnia wartość dodaną?
Praktyczna zasada: jeśli nie czułbyś się pewnie, wyjaśniając użytkownikowi, dlaczego ta strona zasługuje na osobne istnienie obok podobnych stron na Twojej lub innej stronie, prawdopodobnie jest zbyt cienka, aby uzasadniać własny adres URL.
Uniknij problemów z duplikacją treści i zwiększ pozycję swojej strony w wynikach wyszukiwania. Odkryj rozwiązania i najlepsze praktyki dla marketerów afiliacyjnych.
Poznaj sprawdzone metody naprawy problemów z duplikacją treści, w tym przekierowania 301, tagi kanoniczne i dyrektywy noindex. Chroń swoje pozycje SEO dzięki ek...
Dowiedz się, dlaczego zduplikowana treść szkodzi SEO, jak wpływa na pozycje w rankingach oraz poznaj sprawdzone rozwiązania, takie jak tagi kanoniczne i przekie...
Dowiedz się, jak sprawdzić duplikaty treści za pomocą narzędzi takich jak Copyscape, Siteliner i Google Search Console. Poznaj metody ręczne, wykrywanie duplika...
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.


Zgoda na Pliki Cookie
Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our privacy policy.