

Czy Google używa słów kluczowych LSI? Prawda o semantycznym SEO
Dowiedz się, czy Google używa słów kluczowych LSI i jak naprawdę działa nowoczesne semantyczne wyszukiwanie. Poznaj BERT, RankBrain i optymalizację opartą na en...
11 min czytania
Latentne indeksowanie semantyczne (LSI) to technika matematyczna z zakresu przetwarzania języka naturalnego i wyszukiwania informacji, która odkrywa ukryte — lub latentne — zależności między słowami a dokumentami.
Na tej stronie
Latentne indeksowanie semantyczne (LSI) to technika matematyczna z zakresu przetwarzania języka naturalnego i wyszukiwania informacji, która odkrywa ukryte — lub latentne — zależności między słowami a dokumentami. Zamiast dopasowywać dokładne słowa kluczowe, LSI analizuje wzorce współwystępowania słów w zbiorze dokumentów, aby wywnioskować, o czym faktycznie jest każdy dokument.
Rozbicie nazwy na części wyjaśnia tę koncepcję:

Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
LSI działa poprzez sekwencję ściśle określonych kroków matematycznych. Zrozumienie ich — nawet na ogólnym poziomie — wyjaśnia, dlaczego technika ta ma znaczenie i gdzie leżą jej ograniczenia.
LSI zaczyna od skonstruowania macierzy term-dokument. Każdy wiersz reprezentuje unikalny termin z korpusu, każda kolumna reprezentuje dokument, a każda komórka odnotowuje, ile razy dany termin występuje w tym dokumencie — lub, częściej, ważoną wartość, taką jak TF-IDF (częstość terminu–odwrotna częstość dokumentu).
| Dok. 1 | Dok. 2 | Dok. 3 | |
|---|---|---|---|
| samochód | 3 | 0 | 1 |
| auto | 0 | 4 | 1 |
| silnik | 2 | 3 | 0 |
| restauracja | 0 | 0 | 5 |
Ta macierz jest zazwyczaj duża i rzadka — większość komórek ma wartość zero, ponieważ każdy dokument używa jedynie niewielkiej części całkowitego słownictwa.
Podstawową operacją matematyczną w LSI jest rozkład według wartości szczególnych (SVD). SVD rozbija macierz term-dokument na trzy mniejsze macierze:
A ≈ Uₖ Σₖ Vₖᵀ
Zachowując tylko k największych wartości szczególnych (i odrzucając resztę), LSI redukuje macierz do znacznie mniejszej, gęstszej reprezentacji. Ten krok usuwa szum, łączy powiązane terminy i wydobywa ukrytą strukturę semantyczną. Wybór k jest kluczowy: zbyt mała wartość powoduje utratę istotnych różnic; zbyt duża — zatrzymanie szumu. W praktyce k wynosi zazwyczaj od 100 do 300 dla średniej wielkości zbiorów.
Gdy dokumenty i terminy zostaną odwzorowane w zredukowanej przestrzeni semantycznej, ich porównywanie staje się proste. Zapytanie jest rzutowane w tę samą przestrzeń, a jego wektor porównywany z każdym wektorem dokumentu za pomocą podobieństwa cosinusowego — miary określającej kąt między dwoma wektorami, gdzie wartości bliższe 1 oznaczają większe podobieństwo.
Terminy latentne indeksowanie semantyczne (LSI) i analiza latentna semantyczna (LSA) są często używane zamiennie i nie bez powodu: opisują tę samą procedurę matematyczną. Różnica dotyczy zastosowania, a nie techniki.
Krótko mówiąc: LSA to technika analizy; LSI to jej zastosowanie w wyszukiwaniu. Oryginalna publikacja Deerwester i in. (1990) używała terminu „latent semantic indexing”, dlatego środowisko wyszukiwania informacji przyjęło LSI, podczas gdy szersze środowiska NLP i kognitywistyki preferują LSA.
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
LSI zostało wdrożone w wielu rzeczywistych systemach, szczególnie przed rozwojem podejść opartych na sieciach neuronowych.
LSI było jedną z pierwszych technik umożliwiających wyszukiwanie semantyczne — pobieranie dokumentów na podstawie trafności koncepcyjnej, a nie dopasowania słów kluczowych. Wczesne korporacyjne systemy wyszukiwania, katalogi bibliotek cyfrowych i akademickie bazy danych wykorzystywały LSI do poprawy kompletności wyników: odsetka faktycznie znalezionych odpowiednich dokumentów.
Ponieważ LSI odwzorowuje dokumenty we wspólnej przestrzeni semantycznej, naturalnie wspiera grupowanie. Dokumenty na podobne tematy znajdują się blisko siebie w zredukowanej przestrzeni, nawet jeśli nie mają żadnego wspólnego słownictwa. To sprawiło, że LSI było przydatne do automatycznej kategoryzacji tematycznej, przeglądu dokumentów prawnych i wyszukiwania patentów.
Jednym z najczęściej cytowanych zastosowań LSA poza wyszukiwaniem jest Intelligent Essay Assessor, opracowany pod koniec lat 90. System wykorzystywał LSA do porównywania esejów studentów z korpusem tekstów napisanych przez ekspertów, uzyskując wyniki dobrze skorelowane z ocenami ludzkich egzaminatorów. To zastosowanie pokazało, że LSA może uchwycić coś istotnego na temat treści tekstu bez żadnych reguł językowych ani wiedzy dziedzinowej.
Oryginalne badania nad LSA były częściowo motywowane pytaniami z psychologii poznawczej. Landauer i Dumais wykazali, że LSA może odtworzyć aspekty przyswajania słownictwa i efektów torowania semantycznego u ludzi, sugerując, że sama statystyczna struktura ekspozycji na język może wyjaśniać znaczną część tego, jak ludzie uczą się znaczeń słów.
Nie. Google nie używa latentnego indeksowania semantycznego w swoich algorytmach rankingowych. To nie są spekulacje — przedstawiciele Google wyrazili to wprost.
Zamieszanie ma historyczne korzenie. Na początku XXI wieku, gdy algorytm Google stawał się coraz bardziej zaawansowany w rozumieniu kontekstu, specjaliści SEO szukali ram wyjaśniających to, co obserwowali. LSI — rzeczywista, opisana w literaturze technika rozumienia semantycznego — stanowiła wygodną etykietę. Pomysł, że Google może używać czegoś podobnego do LSI, aby „przejrzeć” upychanie słów kluczowych i zrozumieć tematykę stron, był na tyle wiarygodny, że się przyjął.
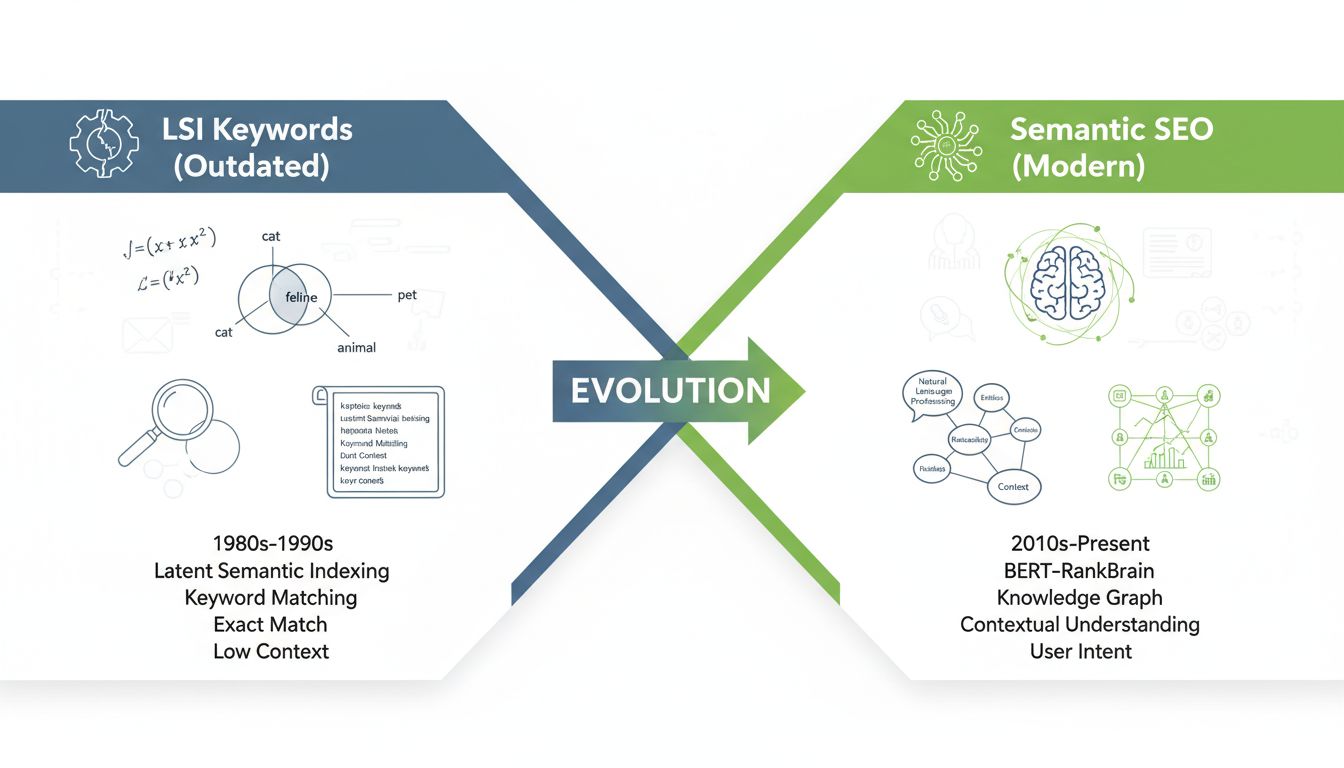
Jednak nowoczesne podejście Google do rozumienia treści jest znacznie bardziej zaawansowane. Systemy takie jak RankBrain (wprowadzony w 2015), neural matching i BERT (2019) wykorzystują głębokie uczenie i architektury transformerowe do modelowania języka. Systemy te przetwarzają kolejność słów, kontekst, relacje między encjami i sygnały interakcji użytkowników — czego LSI nie obsługuje. LSI to technika algebry liniowej działająca na statycznej reprezentacji worka słów; infrastruktura Google jest o rzędy wielkości bardziej złożona.
W połowie lat 2000. narzędzia i blogi SEO zaczęły promować pogląd, że Google używa LSI do identyfikowania powiązanych terminów i karania stron pozbawionych głębi semantycznej. Koncepcja była atrakcyjna: dawała SEO naukowo brzmiące uzasadnienie dla pisania bogatszych treści i taktykę przypominającą listę kontrolną (znajdź słowa kluczowe LSI, wpleć je w treść, uzyskaj wyższą pozycję). Pojawiły się narzędzia rzekomo generujące słowa kluczowe LSI dla dowolnego tematu.
Problem polega na tym, że narracja ta myli dwie różne rzeczy: technikę matematyczną zwaną LSI oraz ogólną praktykę używania powiązanych terminów w treści.
Podstawowa rada — pisz wyczerpujące, bogate tematycznie treści — pozostaje słuszna. Etykieta jest jednak myląca.
W ścisłym, technicznym sensie: nie. Nie istnieje algorytm w Google, który pobiera zapytanie, uruchamia SVD na macierzy term-dokument i zwraca listę „słów kluczowych LSI”, które należy umieścić na stronie.
Istnieje natomiast obserwowalne zjawisko, że strony dobrze pozycjonujące się dla danego zapytania zwykle używają szerszego słownictwa powiązanych terminów. To korelacja, a nie dowód na istnienie mechanizmu opartego na LSI. Nowoczesne wyszukiwarki używają neuronowych modeli językowych wytrenowanych na ogromnych korpusach, aby zrozumieć, że „oszczędność paliwa”, „MPG” i „silnik hybrydowy” są powiązane ze stroną o samochodach — bez budowania macierzy term-dokument ani obliczania pojedynczej wartości szczególnej.
Jeśli budujesz system wyszukiwania, silnik rekomendacji treści lub jakąkolwiek aplikację wymagającą rozumienia podobieństwa semantycznego między tekstami, odpowiedź jest jasna: użyj embeddingów.
LSI ma kilka niszowych zalet. Jest przejrzyste — można podejrzeć wektory terminów i dokumentów i zrozumieć, które wymiary wpływają na podobieństwo. Nie wymaga danych treningowych poza samym zbiorem dokumentów. Działa na skromnym sprzęcie i może być zaimplementowane w kilkudziesięciu linijkach Pythona przy użyciu TruncatedSVD z biblioteki scikit-learn. Dla małego, statycznego zbioru dokumentów — powiedzmy kilku tysięcy opisów produktów na stronie afiliacyjnej — LSI może dać akceptowalne wyniki przy minimalnej złożoności.
Nowoczesne modele embeddingów — czy to sentence transformers typu all-MiniLM-L6-v2, autorskie API od OpenAI czy Cohere, czy modele z otwartymi wagami — uchwycają znacznie bogatsze zależności semantyczne niż LSI kiedykolwiek mogło. Rozumieją kolejność słów, zaprzeczenia, relacje między encjami i semantykę międzyjęzykową. Radzą sobie z polisemią kontekstowo: „bank” jako instytucja finansowa i „bank” jako brzeg rzeki otrzymują różne reprezentacje wektorowe w zależności od otaczających słów.
| Kryterium | LSI | Nowoczesne embeddingi |
|---|---|---|
| Obsługa synonimii | Tak, częściowo | Tak, skutecznie |
| Obsługa polisemii | Nie (jeden wektor na termin) | Tak (kontekstowo) |
| Uwzględnia kolejność słów | Nie (worek słów) | Tak |
| Wymagane dane treningowe | Żadne poza korpusem docelowym | Wstępnie wytrenowane na dużych korpusach |
| Koszt obliczeniowy | Niski | Umiarkowany do wysokiego |
| Interpretowalność | Wysoka (wymiary do podejrzenia) | Niska (wektory czarna skrzynka) |
| Najlepsze dla | Małych, statycznych zbiorów | Produkcyjne wyszukiwanie, RAG, rekomendacje |
Dla każdego projektu, który będzie się rozwijał, obsługiwał prawdziwych użytkowników lub wymagał rozumienia niuansowych zapytań, embeddingi są właściwym wyborem.
Mimo że zostało wyparte w przypadku wyszukiwania na dużą skalę, LSI pozostaje przydatne w kilku konkretnych kontekstach.
LSI to doskonałe narzędzie dydaktyczne. Jego mechanika — budowanie macierzy, rozkładanie jej i mierzenie podobieństwa w zredukowanej przestrzeni — sprawia, że abstrakcyjna koncepcja „podobieństwa semantycznego” staje się konkretna. Studenci, którzy implementują LSI od podstaw, zyskują prawdziwe zrozumienie modeli przestrzeni wektorowej, które bezpośrednio przekłada się na pracę z nowoczesnymi embeddingami.
Dla zbioru kilku tysięcy dokumentów — wewnętrznych wiki, katalogów produktów, umów prawnych — LSI można wdrożyć szybko, bez GPU, kosztów API i infrastruktury do serwowania modeli. Wyniki nie są najwyższej jakości, ale często wystarczająco dobre dla narzędzi wewnętrznych i prototypów.
Naukowcy i inżynierowie wciąż używają LSI jako punktu odniesienia przy ocenie nowych technik wyszukiwania lub modelowania tematycznego. Jeśli Twój wymyślny nowy model neuronowy ledwo przewyższa 30-letnią metodę algebry liniowej, masz problem. LSI wyznacza użyteczną dolną granicę.
Niektóre korporacyjne systemy wyszukiwania i zarządzania dokumentami wdrożyły LSI lata temu i nie mają przekonującego powodu, aby migrować. Jeśli zbiór jest stabilny, wzorce zapytań są dobrze poznane, a użytkownicy są zadowoleni, zastąpienie LSI embeddingami może być rozwiązaniem w poszukiwaniu problemu.
Jeśli LSI nie jest czynnikiem rankingowym Google, a „słowa kluczowe LSI” nie istnieją, co właściwie powinien robić marketer afiliacyjny lub menedżer programu? Odpowiedź jest prostsza — i skuteczniejsza — niż polowanie na magiczną listę słów kluczowych.
Prawdziwy wgląd kryjący się za koncepcją słów kluczowych LSI jest taki, że strony dokładnie omawiające dany temat mają tendencję do wyższych pozycji. Nie wymaga to SVD. Wymaga zrozumienia, jakie pytania ma Twoja grupa docelowa i udzielania na nie odpowiedzi. Dla strony afiliacyjnej recenzującej trackery fitness oznacza to omówienie żywotności baterii, wodoodporności, dokładności pomiaru tętna, jakości aplikacji towarzyszącej i porównania cen — nie dlatego, że algorytm wymaga tych terminów, ale dlatego, że wymagają ich czytelnicy.
Narzędzia do badania słów kluczowych są cenne do odkrywania powiązanych zapytań, zrozumienia wolumenu wyszukiwań i analizowania treści konkurencji. Używaj ich do tego. Nie używaj ich, ponieważ twierdzą, że generują „słowa kluczowe LSI”. Autouzupełnianie Google, pole „People also ask” i „Related searches” na dole SERP są darmowe i bezpośrednio odzwierciedlają rzeczywiste zapytania użytkowników — są bardziej przydatne niż jakiekolwiek narzędzie LSI innych firm.
Nowoczesne podejście Google do rozumienia treści opiera się na encjach — rzeczywistych rzeczach, osobach, miejscach i koncepcjach — oraz ich relacjach. Gdy piszesz o produkcie, wymień markę, kategorię, przypadek użycia, alternatywy i odpowiednie specyfikacje. To są encje. Naturalne ich uwzględnienie sygnalizuje głębię tematyczną w sposób, który system uczenia maszynowego może rozpoznać, bez potrzeby stosowania przestarzałej techniki dekompozycji macierzy.
LSI ma dobrze udokumentowane ograniczenia, które wyjaśniają, dlaczego zostało w dużej mierze wyparte.
LSI traktuje każdy dokument jako nieuporządkowany zbiór słów. Kolejność słów, składnia i struktura gramatyczna są całkowicie ignorowane. „Pies ugryzł człowieka” i „człowiek ugryzł psa” dają identyczne reprezentacje. Dla wielu rzeczywistych zapytań ma to znaczenie.
W LSI każdy termin otrzymuje dokładnie jeden wektor — niezależnie od kontekstu. Słowo „zamek” (budowla obronna vs. mechanizm w drzwiach) ma tę samą reprezentację w każdym dokumencie. Nowoczesne embeddingi kontekstowe rozwiązują ten problem, tworząc różne wektory dla tego samego słowa w różnych kontekstach.
LSI buduje swoją przestrzeń semantyczną na podstawie ustalonego zbioru dokumentów. Dodawanie nowych dokumentów wymaga ponownego obliczenia SVD — lub co najmniej rzutowania nowych dokumentów w istniejącą przestrzeń, co może nie uwzględniać dobrze nowego słownictwa. To sprawia, że LSI nie nadaje się do dynamicznych zbiorów, takich jak kanały informacyjne czy stale aktualizowane katalogi produktów.
SVD jest kosztowne obliczeniowo w przypadku dużych macierzy. Macierz term-dokument dla zbioru na skalę internetową byłaby nie do opanowania. Technika została zaprojektowana dla zbiorów od tysięcy do kilkudziesięciu tysięcy dokumentów — o rzędy wielkości mniejszych niż te, którymi zarządzają nowoczesne wyszukiwarki.
LSI nie rozróżnia „dobry” od „niedobry” — oba zawierają słowo „dobry” w podobnej odległości od innych terminów. Sentyment, sarkazm i subtelne różnice znaczeniowe są poza jego zasięgiem.
Wyrażenie „słowa kluczowe LSI” jest często używane luźno w poradach SEO. Powiązane słowo nie jest dowodem na to, że wyszukiwarka używa latentnego indeksowania semantycznego. W przypadku porównania afiliacyjnego lub przewodnika po produkcie odpowiadaj na rzeczywiste pytania kupujących i wyjaśniaj istotne koncepcje naturalnie; nie dodawaj listy rzekomych terminów LSI w pogoni za pozycjami.
Dowiedz się, jak wykorzystanie LSI i semantycznych słów kluczowych może poprawić trafność wyszukiwania Twoich treści i zwiększyć ruch organiczny. Poznaj rozwiązania Post Affiliate Pro dla marketerów afiliacyjnych.
Dowiedz się, czy Google używa słów kluczowych LSI i jak naprawdę działa nowoczesne semantyczne wyszukiwanie. Poznaj BERT, RankBrain i optymalizację opartą na en...

Dowiedz się, dlaczego słowa kluczowe LSI powinny uzupełniać, a nie zastępować, Twoje główne słowa kluczowe. Odkryj, jak semantyczne słowa kluczowe zwiększają tr...
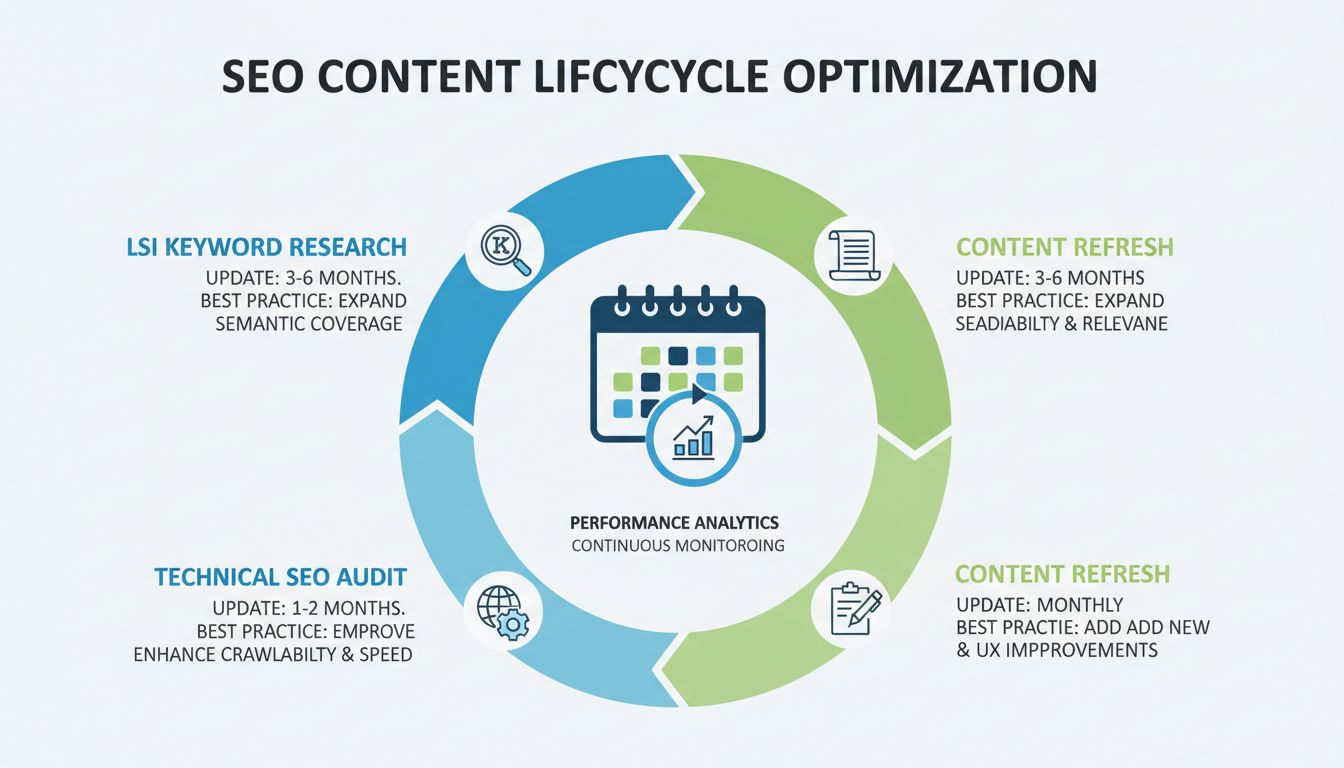
Poznaj optymalną częstotliwość aktualizowania treści o słowa kluczowe LSI. Odkryj najlepsze praktyki w zakresie researchu słów kluczowych, optymalizacji on-page...
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.
Zgoda na Pliki Cookie
Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our privacy policy.