Pająk wyszukiwarki to zautomatyzowany program — nazywany również web crawlerem, botem pająkiem lub po prostu botem — który systematycznie przegląda sieć WWW w celu odkrywania, odczytywania i gromadzenia informacji ze stron internetowych.
SEO
DigitalMarketing
AffiliateMarketing
WebCrawlers
Spiders
Dokumentacja crawlerów Google
opisuje kategorie crawlerów i fetcherów używane przez Google. Korzystaj z tej dokumentacji, sprawdzając, w jaki sposób dany crawler Google uzyskuje dostęp do witryny afiliacyjnej.
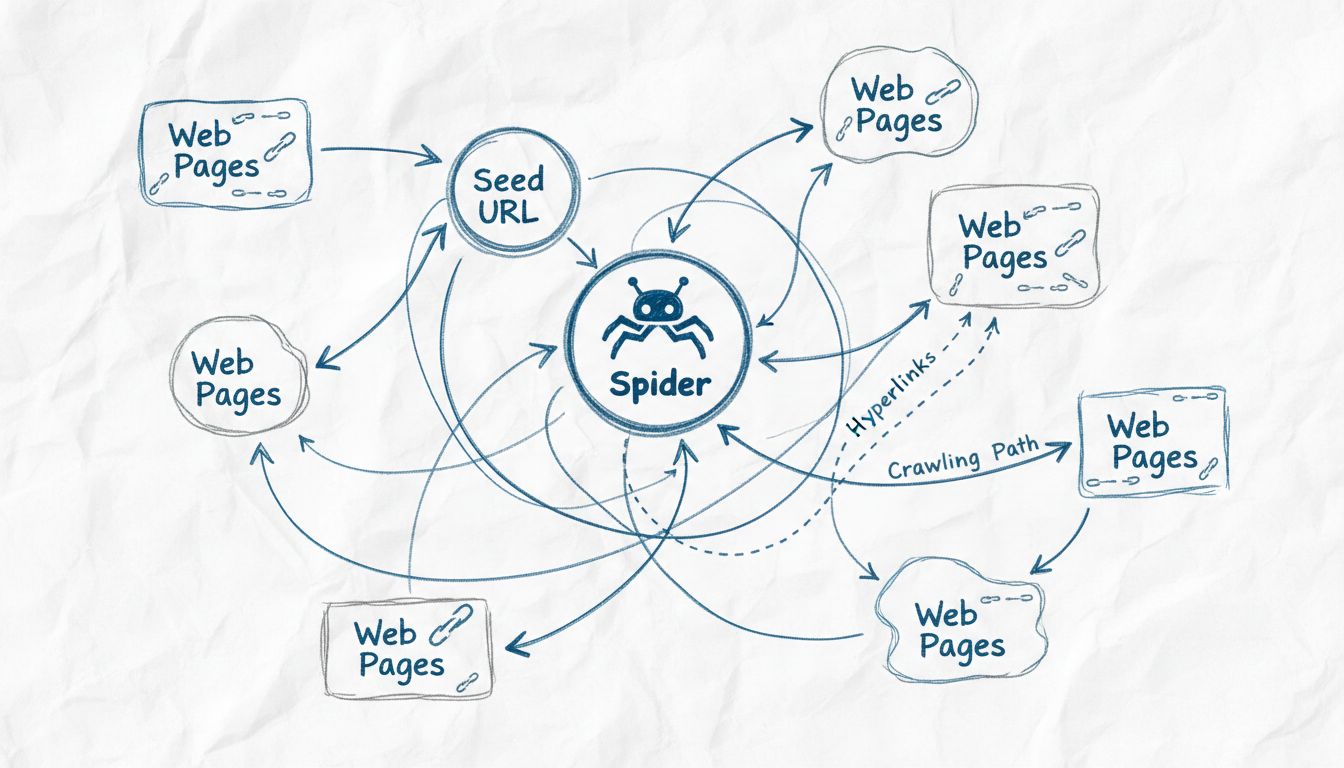
Pająk wyszukiwarki to zautomatyzowany program — nazywany również web crawlerem, botem pająkiem lub po prostu botem — który systematycznie przegląda sieć WWW w celu odkrywania, odczytywania i gromadzenia informacji ze stron internetowych. Dane zebrane przez pająka są przesyłane z powrotem do wyszukiwarki, która porządkuje je w ogromnej bazie danych zwanej indeksem. Gdy ktoś wpisuje zapytanie, wyszukiwarka pobiera odpowiednie wyniki z tego indeksu, a nie z żywej sieci.
Termin „pająk" pochodzi od sposobu, w jaki te programy poruszają się po sieci: podążają za hiperłączami ze strony na stronę, podobnie jak pająk przemieszcza się po nitkach swojej pajęczyny. Najwcześniejszym dobrze znanym crawlerem był WebCrawler, uruchomiony w 1994 roku, który spopularyzował tę metaforę.
Podstawowa definicja
Pająk wyszukiwarki to zautomatyzowany program — nazywany również web crawlerem, botem pająkiem lub po prostu botem — który systematycznie przegląda sieć WWW w celu odkrywania, odczytywania i gromadzenia informacji ze stron internetowych. Dane zebrane przez pająka są przesyłane z powrotem do wyszukiwarki, która porządkuje je w ogromnej bazie danych zwanej indeksem. Gdy ktoś wpisuje zapytanie, wyszukiwarka pobiera odpowiednie wyniki z tego indeksu, a nie z żywej sieci.
Termin „pająk" pochodzi od sposobu, w jaki te programy poruszają się po sieci: podążają za hiperłączami ze strony na stronę, podobnie jak pająk przemieszcza się po nitkach swojej pajęczyny. Najwcześniejszym dobrze znanym crawlerem był WebCrawler, uruchomiony w 1994 roku, który spopularyzował tę metaforę.
Pająk, crawler czy bot — jaka jest różnica?
Google używa Googlebota, Bing używa Bingbota — oba są pająkami pełniącymi tę samą podstawową funkcję.
Uruchom swój program partnerski już dziś
Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
Zrozumienie procesu indeksowania pomaga właścicielom witryn podejmować lepsze decyzje dotyczące struktury strony, priorytetów treści i technicznego SEO.
Adresy URL nasion i odkrywanie
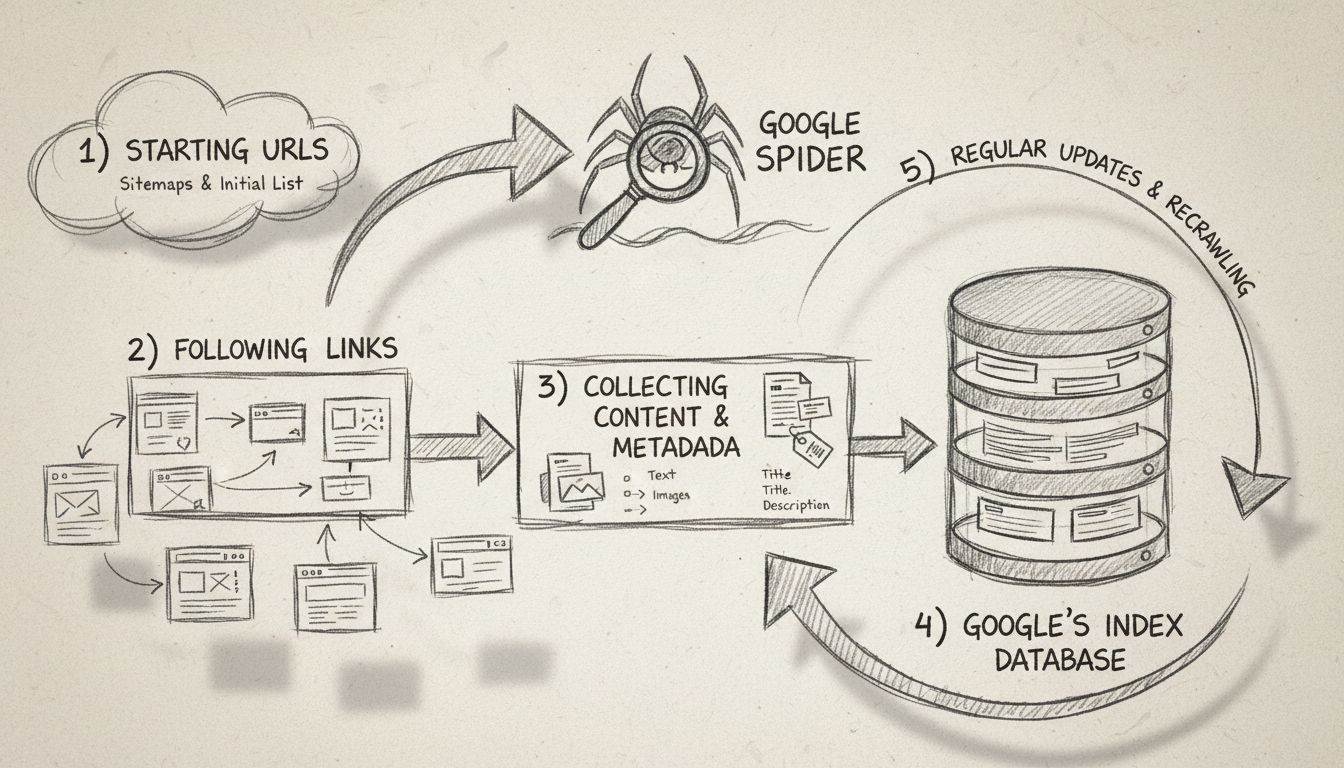
Każdy pająk zaczyna od listy znanych adresów internetowych zwanych adresami URL nasion (seed URLs). Mogą one pochodzić z wcześniej przeszukanych stron, przesłanych map witryn XML lub linków odkrytych podczas wcześniejszych indeksowań. Z każdego nasiona pająk pobiera stronę i wyodrębnia wszystkie zawarte w niej hiperłącza. Linki te tworzą kolejkę — czasami zwaną granicą indeksowania (crawl frontier) — stron do odwiedzenia w następnej kolejności.
Indeksowanie, renderowanie i pozycjonowanie w indeksie
Gdy pająk dociera do strony, wykonuje trzy czynności:
Żąda strony — Pająk wysyła żądanie HTTP, tak jak robi to przeglądarka. Identyfikuje się za pomocą nagłówka User-Agent (np. Googlebot/2.1).
Renderuje i odczytuje treść — Nowoczesne pająki, w tym Googlebot, renderują JavaScript i przetwarzają pełny model DOM (Document Object Model). Odczytują widoczny tekst, meta tagi, strukturę nagłówków, atrybuty alt obrazów oraz znaczniki danych strukturalnych.
Wysyła dane do indeksu — Wyodrębniona treść trafia do potoku indeksowania wyszukiwarki, gdzie jest analizowana, oceniana pod kątem trafności i jakości, a następnie przechowywana do wyszukiwania.
Pętla indeksowania w praktyce
Proces odbywa się w ciągłej pętli:
Odkryj adres URL → Pobierz stronę → Przeanalizuj treść i wyodrębnij linki → Dodaj nowe adresy URL do kolejki → Powtórz
Pająk sprawdza również plik robots.txt przed przeszukaniem jakiejkolwiek strony w domenie. Jeśli plik blokuje daną ścieżkę, dobrze wychowany pająk ją pominie. Pająki przestrzegają również meta tagów robots i nagłówków HTTP X-Robots-Tag, które instruują je, aby nie indeksować strony lub nie podążać za jej linkami.
Jakie są różne pająki wyszukiwarek?
Każda duża wyszukiwarka obsługuje własnego pająka. Oto te, które najprawdopodobniej odwiedzą Twoją witrynę:
Nazwa pająka
Wyszukiwarka
Token User-Agent
Googlebot
Google
Googlebot
Bingbot
Bing
Bingbot
Slurp Bot
Yahoo (napędzany przez Bing)
Slurp
DuckDuckBot
DuckDuckGo
DuckDuckBot
Baiduspider
Baidu (Chiny)
Baiduspider
Yandex Bot
Yandex (Rosja)
YandexBot
Applebot
Apple (Siri, Spotlight)
Applebot
Googlebot
Googlebot występuje w dwóch wariantach: crawler desktopowy symulujący przeglądarkę komputerową oraz crawler mobilny symulujący smartfon. Odkąd Google przeszło na indeksowanie mobile-first, mobilny Googlebot jest głównym crawlerem dla zdecydowanej większości witryn.
Bingbot, DuckDuckBot i inne
Bingbot obsługuje indeks Bing, a także dostarcza wyniki Yahoo i innym partnerom syndykacyjnym. DuckDuckBot indeksuje dla DuckDuckGo, które uzupełnia swój własny indeks wynikami z Bing. Baiduspider i Yandex Bot obsługują odpowiednio rynek chiński i rosyjski — warto zezwolić im na indeksowanie, jeśli masz odbiorców w tych regionach.
Dołącz do naszego newslettera
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
Co mogą zobaczyć pająki wyszukiwarek?
Treści i HTML, które przetwarzają
Pająki wyszukiwarek mogą zobaczyć wszystkie poniższe elementy, gdy odwiedzają stronę:
Widoczny tekst (nagłówki, akapity, listy)
Struktura HTML i elementy semantyczne
Meta tagi (tytuł, opis, robots)
Tekst alternatywny obrazów i nazwy plików
Hiperłącza wewnętrzne i zewnętrzne
Dane strukturalne (znaczniki Schema.org)
Tagi kanoniczne i adnotacje hreflang
Kody odpowiedzi strony (200, 301, 404 itd.)
Czego pająki nie widzą
Pająki nie „widzą" stron tak jak człowiek. Treści osadzone w obrazach bez tekstu alternatywnego, tekst renderowany wewnątrz złożonego JavaScriptu, który nie wykonuje się poprawnie, oraz treści za paywallem lub wymagające logowania są niewidoczne dla większości pająków. Interaktywne elementy, takie jak formularze, menu rozwijane i treści z nieskończonym przewijaniem wymagające kliknięć użytkownika, również mogą zostać pominięte, chyba że strona używa odpowiedniego renderowania po stronie serwera lub technik renderowania dynamicznego.
Czym jest budżet indeksowania i dlaczego ma znaczenie?
Budżet indeksowania to liczba stron, którą pająk wyszukiwarki przeszuka na Twojej witrynie w danym okresie. Google określa budżet indeksowania na podstawie dwóch czynników:
Limit szybkości indeksowania — jak szybko Googlebot może pobierać strony bez przeciążania serwera.
Popyt na indeksowanie — jak bardzo Google chce indeksować Twoje strony, co wynika z popularności, aktualności i rozmiaru witryny.
W przypadku dużych witryn — katalogów e-commerce, serwisów informacyjnych lub stron afiliacyjnych z tysiącami stron produktowych — budżet indeksowania ma znaczenie. Jeśli pająki spędzają czas na adresach URL o niskiej wartości (parametry filtrów, ID sesji, zduplikowane strony), mogą nie dotrzeć do ważnych treści przed zamknięciem okna indeksowania.
Jak zoptymalizować budżet indeksowania
Zablokuj adresy URL o niskiej wartości w robots.txt (strony wyników wyszukiwania, widoki filtrowane, ścieżki administracyjne).
Używaj tagów kanonicznych do konsolidacji zduplikowanych stron.
Utrzymuj mapę witryny XML w czystości i aktualności.
Popraw czas odpowiedzi serwera — szybsze strony są częściej indeksowane.
Napraw uszkodzone linki i łańcuchy przekierowań, które marnują zasoby indeksowania.
Jak kontrolować pająki wyszukiwarek na swojej stronie?
Masz trzy główne narzędzia do kierowania zachowaniem pająków.
Korzystanie z robots.txt
Plik robots.txt, umieszczony w katalogu głównym domeny, informuje pająki, które części witryny mogą, a których nie mogą odwiedzać. Używa prostej składni:
Ten przykład blokuje wszystkim pająkom indeksowanie ścieżek /admin/ i /search/. Możesz kierować blokady do konkretnych pająków, używając ich tokena user-agent:
User-agent: Googlebot
Disallow: /private/
Plik robots.txt to prośba, a nie polecenie. Złośliwe boty mogą go ignorować, ale wszystkie legalne pająki wyszukiwarek go przestrzegają.
Meta tagi robots i nagłówki X-Robots
Do kontroli na poziomie strony użyj meta tagu robots w sekcji HTML <head>:
<metaname="robots"content="noindex, nofollow">
Instruuje to pająki, aby nie indeksowały strony i nie podążały za jej linkami. Te same dyrektywy można wysłać jako nagłówki HTTP (X-Robots-Tag), co jest przydatne w przypadku plików innych niż HTML, takich jak PDF.
Mapy witryn XML
Mapa witryny XML zawiera listę adresów URL, które mają być priorytetowo traktowane przez pająki. Prześlij ją przez Google Search Console lub Bing Webmaster Tools. Mapa witryny nie gwarantuje indeksowania, ale pomaga pająkom szybciej odkrywać nowe i zaktualizowane strony — szczególnie w witrynach o głębokiej architekturze lub ograniczonym linkowaniu wewnętrznym.
Web crawlery a web scrapery — jaka jest różnica?
Te terminy są często mylone, ale opisują różne cele:
Aspekt
Web Crawler (Pająk)
Web Scraper
Cel
Odkrywanie i indeksowanie stron dla wyszukiwania
Wyodrębnianie konkretnych danych ze stron
Operator
Wyszukiwarki (Google, Bing)
Osoby prywatne, firmy, badacze
Zakres
Szeroki — cała dostępna sieć
Ukierunkowany — konkretne witryny lub punkty danych
Wynik
Indeks z możliwością wyszukiwania
Dane strukturalne (CSV, baza danych, API)
Przestrzega robots.txt
Tak (legalne)
Różnie; wiele scraperów to ignoruje
Pająk tworzy mapę; scraper wydobywa dane z terenu. Oba są zautomatyzowane, ale służą zasadniczo różnym celom. Niektóre narzędzia, takie jak Screaming Frog SEO Spider, zacierają granicę — indeksują jak pająk, ale są używane do audytu witryn, a nie do indeksowania wyszukiwarki.
Czy pająki sieciowe są szkodliwe?
Nie z natury. Legalne pająki wyszukiwarek są korzystne — bez nich Twoja strona nie pojawiłaby się w wynikach wyszukiwania. Jednak nie wszystkie boty są przyjazne.
Dobre boty a złe boty
Dobre boty jasno się identyfikują, przestrzegają robots.txt, indeksują w rozsądnym tempie i dostarczają wartość (widoczność w wyszukiwarkach, monitorowanie witryn, archiwizacja).
Złe boty mogą kopiować treści w celu ponownego publikowania, skanować w poszukiwaniu luk w zabezpieczeniach, próbować przejąć konta lub przeciążać serwer nadmiernymi żądaniami.
Oznaki szkodliwej aktywności botów obejmują:
Skoki obciążenia serwera od nieznanych user-agentów
Treści pojawiające się na innych stronach bez podania źródła
Ruch indeksujący na stronach, które powinny być zablokowane
Wielokrotne żądania do stron logowania lub formularzy
Jak chronić swoją witrynę
Przejrzyj logi serwera pod kątem podejrzanych stringów user-agent i zakresów IP.
Użyj CDN lub zapory aplikacji internetowej (WAF) z funkcjami zarządzania botami.
Zablokuj znane złe boty w robots.txt — choć złośliwe je zignorują, pomaga to w przypadku niektórych.
Ogranicz szybkość agresywnych crawlerów na poziomie serwera lub CDN.
Czy ChatGPT to web crawler?
GPTBot od OpenAI to web crawler używany do zbierania danych treningowych dla modeli AI. Nie jest pająkiem wyszukiwarki — nie obsługuje publicznego indeksu wyszukiwania.
User-agent: GPTBot
Disallow: /
Podobnie ClaudeBot od Anthropic oraz Google-Extended (używany do trenowania AI przez Google, oddzielny od Googlebota) mogą być kontrolowane za pomocą tego samego mechanizmu. Te crawlery nie wpływają na pozycje w wynikach wyszukiwania — zablokowanie ich nie zaszkodzi Twojemu SEO.
Która wyszukiwarka Cię nie śledzi?
Jeśli zależy Ci na prywatności, DuckDuckGo i Brave Search to dwie główne wyszukiwarki, które nie śledzą użytkowników ani nie budują profili osobistych. Obie obsługują własne pająki (DuckDuckBot i crawler Brave) i uzupełniają swoje indeksy wynikami z innych źródeł. Opierają się na kontekstowych słowach kluczowych, a nie na historii użytkownika, aby rankingować wyniki, co oznacza, że SEO na stronie ma jeszcze większe znaczenie dla widoczności na tych platformach.
Pająki a marketing afiliacyjny — dlaczego to ważne
Pająki wyszukiwarek bezpośrednio wpływają na każdą rolę w ekosystemie marketingu afiliacyjnego.
Dla reklamodawców (marek prowadzących programy afiliacyjne)
Strony docelowe programu afiliacyjnego, strony z warunkami i treści promocyjne muszą być możliwe do przeszukania i indeksowania. Jeśli pająki nie mogą dotrzeć do informacji o Twoim programie, potencjalni afilianci szukający „[Twoja marka] program afiliacyjny" mogą nie znaleźć Cię organicznie. Kluczowe kroki:
Upewnij się, że strona rejestracji afilianta znajduje się w mapie witryny XML i nie jest blokowana przez robots.txt.
Używaj czystych struktur URL — unikaj ID sesji i zbędnych parametrów, które tworzą zduplikowane strony i marnują budżet indeksowania.
Monitoruj Google Search Console pod kątem błędów indeksowania na kluczowych stronach konwersji.
Dla wydawców (afiliantów)
Każda publikowana przez Ciebie recenzja produktu, artykuł porównawczy i przewodnik muszą być znajdowane poprzez wyszukiwanie — a to oznacza bycie przeszukiwanym i indeksowanym. Pająki są strażnikami. Najlepsze praktyki:
Linkowanie wewnętrzne ma znaczenie: Pająki podążają za linkami. Dobrze powiązany klaster artykułów sygnalizuje ważność i pomaga pająkom szybciej odkrywać nowe treści.
Świeżość wyzwala ponowne indeksowanie: Aktualizowanie istniejących treści i zmiana daty lastmod w mapie witryny może skłonić pająki do wcześniejszego ponownego odwiedzenia Twoich stron.
Unikaj cienkich stron afiliacyjnych: Strony z niewielką ilością oryginalnych treści i wieloma linkami afiliacyjnymi mogą zostać sklasyfikowane jako niskiej jakości przez algorytmy wyszukiwania. Pająki nadal je indeksują, ale mogą nie uzyskać dobrej pozycji — lub żadnej.
Dla menedżerów programów afiliacyjnych
Zrozumienie zachowania pająków pomaga lepiej wspierać afiliantów:
Jeśli treści afilianta nie uzyskują dobrej pozycji, problem może być techniczny — sprawdź, czy jego strony są indeksowane (użyj wyszukiwania site:) i czy przypadkiem nie blokują pająków.
Podczas migracji platformy afiliacyjnej lub zmiany adresów URL używaj przekierowań 301 i niezwłocznie aktualizuj mapę witryny. Pająki podążą za przekierowaniami i zaktualizują indeks, zachowując wartość linków afiliantów.
Zagadnienia budżetu indeksowania dotyczą dużych witryn afiliacyjnych z tysiącami stron produktowych. Pomóż afiliantom zrozumieć, które strony priorytetyzować w swoich mapach witryn.
Najczęściej zadawane pytania
Pająki wyszukiwarek systematycznie przeglądają sieć, pobierając treści stron i podążając za linkami w celu odkrywania nowych stron. Zebrane dane przesyłają z powrotem do wyszukiwarki, która porządkuje je w indeksie wykorzystywanym do odpowiadania na zapytania.
Pająk zaczyna od listy znanych adresów URL (nasion), pobiera każdą stronę, wyodrębnia jej treść i linki, a następnie dodaje nowe adresy URL do kolejki indeksowania. Przed przeszukaniem sprawdza reguły robots.txt, renderuje treść strony i przekazuje dane do potoku indeksowania. Proces ten powtarza się w sposób ciągły.
Główne typy to: crawlery wyszukiwarek (Googlebot, Bingbot), crawlery audytowe (Screaming Frog, Sitebulb), crawlery archiwizujące (bot Internet Archive) oraz crawlery zbierające dane, wykorzystywane do monitorowania cen, badań lub trenowania AI. Tylko crawlery wyszukiwarek mają bezpośredni wpływ na pozycję Twojej strony w wynikach wyszukiwania.
Regularnie publikuj nowe treści, aktualizuj istniejące strony, prześlij dokładną mapę witryny XML przez Google Search Console, popraw szybkość ładowania strony oraz buduj linki wewnętrzne do nowych treści z już zaindeksowanych stron. Strony o silnej autorytecie i częstych aktualizacjach są indeksowane częściej.
Web crawlery indeksują strony dla wyszukiwarek; web scrapery wyodrębniają konkretne dane do innych celów (analiza cen, generowanie leadów, badania). Crawlery są szerokie i eksploracyjne; scrapery są ukierunkowane. Legalne crawlery przestrzegają robots.txt; scrapery często tego nie robią.
Legalne pająki wyszukiwarek nie są szkodliwe — są niezbędne, aby Twoja strona pojawiała się w wynikach wyszukiwania. Jednak złośliwe boty, które ignorują robots.txt, kopiują treści, szukają luk w zabezpieczeniach lub przeciążają serwery, mogą być szkodliwe. Używaj monitorowania logów serwera i narzędzi do zarządzania botami, aby rozróżniać i blokować złe boty.
Budżet indeksowania to liczba stron, którą pająk wyszukiwarki przeszuka na Twojej stronie w danym okresie. Google określa go, równoważąc szybkość indeksowania bez przeciążania serwera (limit szybkości indeksowania) z tym, jak bardzo chce przeszukiwać Twoje strony (popyt na indeksowanie). Większość małych stron nigdy nie musi się tym martwić.
Użyj meta tagu robots noindex lub nagłówka HTTP X-Robots-Tag na stronach, które chcesz wykluczyć z indeksu. Zablokuj indeksowanie wrażliwych katalogów przez robots.txt. W przypadku całych witryn w fazie rozwoju użyj środowiska stagingowego chronionego hasłem lub zastosuj noindex dla całej witryny do czasu premiery.
Prześlij mapę witryny XML przez Google Search Console i Bing Webmaster Tools. Upewnij się, że strony nie są blokowane przez robots.txt ani tagi noindex. Buduj linki wewnętrzne do nowych stron z już zaindeksowanych treści. Użyj narzędzia URL Inspection w Search Console, aby poprosić o indeksowanie poszczególnych adresów URL.
Zwiększ skuteczność marketingu afiliacyjnego dzięki SEO
Dowiedz się, jak zrozumienie działania pająków sieciowych może pomóc Ci zoptymalizować witrynę pod kątem lepszych pozycji w wyszukiwarkach i wyższych przychodów z afiliacji.
Dlaczego crawlery internetowe nazywane są pająkami? Zrozumienie technologii indeksowania sieci
Dowiedz się, dlaczego crawlery internetowe nazywane są pająkami, jak działają i jaką kluczową rolę odgrywają w indeksowaniu przez wyszukiwarki. Poznaj mechanizm...
Czym jest Google Spider? Kompletny przewodnik po indeksowaniu przez Googlebota
Dowiedz się, czym jest Google Spider (Googlebot), jak przeszukuje i indeksuje strony internetowe oraz dlaczego jest kluczowy dla SEO. Odkryj, jak zoptymalizować...
8 min czytania
Będziesz w dobrych rękach!
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.