


Pająk wyszukiwarki internetowej
Pająk wyszukiwarki to zautomatyzowany bot, który przeszukuje strony internetowe w celu indeksowania treści dla wyszukiwarek takich jak Google i Bing. Dowiedz si...
10 min czytania
SEO
DigitalMarketing
+3
Wykrywanie pająków to proces identyfikacji zautomatyzowanych programów — zwanych pająkami, robotami indeksującymi lub botami — które odwiedzają stronę internetową, oraz określania, czy każdy z nich służy uzasadnionemu celowi, czy stanowi zagrożenie dla integralności danych, wydatków reklamowych lub przychodów programu afiliacyjnego.
Wykrywanie pająków to proces identyfikacji zautomatyzowanych programów — zwanych pająkami, robotami indeksującymi lub botami — które odwiedzają stronę internetową, oraz określania, czy każdy z nich służy uzasadnionemu celowi, czy stanowi zagrożenie dla integralności danych, wydatków reklamowych lub przychodów programu afiliacyjnego.
Wykrywanie pająków to dyscyplina z zakresu bezpieczeństwa i analityki, która identyfikuje zautomatyzowanych klientów HTTP poprzez badanie ich sygnatur technicznych, wzorców behawioralnych i charakterystyk sieciowych. Termin „pająk" pochodzi od sposobu, w jaki te programy przeszukują sieć — podążając za hiperłączami od strony do strony, tak jak pająk przemierza swoją sieć.
W praktyce wykrywanie pająków odpowiada na jedno pytanie dotyczące każdego odwiedzającego: czy to człowiek, przyjazny bot, czy złośliwy skrypt? Odpowiedź decyduje o tym, czy wizyta zostanie policzona w analityce, czy kliknięcie uruchomi prowizję i czy lead trafi do Twojego CRM.
Te trzy terminy są często używane zamiennie, ale niosą różne konotacje w zależności od kontekstu:
Nie cały zautomatyzowany ruch jest wrogi. Skuteczne wykrywanie pająków rozróżnia kategorie:
| Kategoria bota | Przykłady | Czy blokować? |
|---|---|---|
| Roboty indeksujące wyszukiwarki | Googlebot, Bingbot, YandexBot | Nie — blokowanie usuwa Cię z wyników wyszukiwania |
| Narzędzia SEO i marketingowe | AhrefsBot, SemrushBot, Moz Dotbot | Indywidualnie — zużywają zasoby, ale mogą pomóc w widoczności |
| Monitorowanie i walidacja | IAB Tech Lab crawler, monitory dostępności | Nie — weryfikują ads.txt, SSL i stan strony |
| Skrobaki treści | Niezidentyfikowane boty kopiujące treść | Tak — kradną treść i nie wnoszą wartości |
| Boty do oszustw kliknięć | Skrypty klikające w linki afiliacyjne lub reklamy | Tak — bezpośrednio kradną z budżetu |
| Boty do oszustw leadów | Automatyczne wypełniacze formularzy wysyłające fałszywe rejestracje | Tak — marnują wydatki CPA i zanieczyszczają CRM |
| Narzędzia do kradzieży danych uwierzytelniających | Boty testujące skradzione dane logowania | Tak — stanowią zagrożenie bezpieczeństwa |
Granica między „dobrym" a „złym" nie zawsze jest ostra. Robot SEO z legalnego narzędzia może wciąż zniekształcać Twoją analitykę, jeśli liczysz jego wizyty jako ruch ludzki. Wykrywanie pająków dostarcza danych do podejmowania świadomych decyzji, a nie tylko bezmyślnego blokowania wszystkiego.
Wykrywanie pająków to dyscyplina z zakresu bezpieczeństwa i analityki, która identyfikuje zautomatyzowanych klientów HTTP poprzez badanie ich sygnatur technicznych, wzorców behawioralnych i charakterystyk sieciowych. Termin „pająk" pochodzi od sposobu, w jaki te programy przeszukują sieć — podążając za hiperłączami od strony do strony, tak jak pająk przemierza swoją sieć.
W praktyce wykrywanie pająków odpowiada na jedno pytanie dotyczące każdego odwiedzającego: czy to człowiek, przyjazny bot, czy złośliwy skrypt? Odpowiedź decyduje o tym, czy wizyta zostanie policzona w analityce, czy kliknięcie uruchomi prowizję i czy lead trafi do Twojego CRM.
Te trzy terminy są często używane zamiennie, ale niosą różne konotacje w zależności od kontekstu:
Nie cały zautomatyzowany ruch jest wrogi. Skuteczne wykrywanie pająków rozróżnia kategorie:
| Kategoria bota | Przykłady | Czy blokować? |
|---|---|---|
| Roboty indeksujące wyszukiwarki | Googlebot, Bingbot, YandexBot | Nie — blokowanie usuwa Cię z wyników wyszukiwania |
| Narzędzia SEO i marketingowe | AhrefsBot, SemrushBot, Moz Dotbot | Indywidualnie — zużywają zasoby, ale mogą pomóc w widoczności |
| Monitorowanie i walidacja | IAB Tech Lab crawler, monitory dostępności | Nie — weryfikują ads.txt, SSL i stan strony |
| Skrobaki treści | Niezidentyfikowane boty kopiujące treść | Tak — kradną treść i nie wnoszą wartości |
| Boty do oszustw kliknięć | Skrypty klikające w linki afiliacyjne lub reklamy | Tak — bezpośrednio kradną z budżetu |
| Boty do oszustw leadów | Automatyczne wypełniacze formularzy wysyłające fałszywe rejestracje | Tak — marnują wydatki CPA i zanieczyszczają CRM |
| Narzędzia do kradzieży danych uwierzytelniających | Boty testujące skradzione dane logowania | Tak — stanowią zagrożenie bezpieczeństwa |
Granica między „dobrym" a „złym" nie zawsze jest ostra. Robot SEO z legalnego narzędzia może wciąż zniekształcać Twoją analitykę, jeśli liczysz jego wizyty jako ruch ludzki. Wykrywanie pająków dostarcza danych do podejmowania świadomych decyzji, a nie tylko bezmyślnego blokowania wszystkiego.

Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
Nowoczesne wykrywanie pająków łączy wiele sygnałów. Żadne pojedyncze sprawdzenie nie jest wiarygodne samo w sobie — zaawansowane boty fałszują user-agenty, rotują adresy IP i naśladują ludzkie zachowanie. Skuteczne wykrywanie nakłada na siebie kilka metod.
Każde żądanie HTTP zawiera nagłówek User-Agent, który identyfikuje klienta wysyłającego żądanie. Uzasadnione roboty indeksujące deklarują się otwarcie:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 (compatible; Bingbot/2.0; +http://www.bing.com/bingbot.htm)
Ograniczenie: Każdy bot może podać się za Googlebota, kopiując jego ciąg user-agent. Analiza user-agent to filtr pierwszego przejścia, a nie ostateczne sprawdzenie.
Niezawodnym sposobem weryfikacji deklarowanej tożsamości robota indeksującego jest krzyżowe sprawdzenie jego adresu IP. Dla głównych wyszukiwarek proces wygląda następująco:
*.googlebot.com dla Googlebota).Jeśli wszystkie cztery kroki są zgodne, robot indeksujący jest autentyczny. Google, Bing i Yandex publikują swoje zakresy IP i metody weryfikacji. Każdy bot, który twierdzi, że jest Googlebotem, ale łączy się z adresu IP centrum danych AWS, jest natychmiast oznaczany.
Ludzie przeglądają w nieprzewidywalny sposób. Robią pauzy między przeglądaniem stron, przewijają z różną prędkością i klikają w wzorce, które trudno odtworzyć programowo. Boty pozostawiają inne odciski palców:
Sygnały behawioralne są trudniejsze do sfałszowania niż nagłówki czy adresy IP. Wymagają od operatora bota symulowania ludzkiej interakcji, co zwiększa koszt i złożoność ataku na tyle, by odstraszyć wielu oszustów.
Pobieranie odcisków palców urządzeń zbiera atrybuty łączącego się klienta — wersję przeglądarki, zainstalowane czcionki, rozdzielczość ekranu, renderer WebGL i dziesiątki innych sygnałów — aby utworzyć unikalny identyfikator. Gdy ten sam odcisk palca pojawia się wśród setek „różnych" odwiedzających lub gdy odcisk palca nie pasuje do deklarowanego user-agenta, systemy wykrywania pająków oznaczają taki ruch.
| Metoda | Co sprawdza | Zalety | Słabości |
|---|---|---|---|
| Analiza user-agent | Ciąg identyfikujący przeglądarkę/klienta | Szybki, bezkosztowy filtr wstępny | Łatwy do sfałszowania |
| Weryfikacja IP/odwrotnego DNS | Pochodzenie sieciowe i zgodność nazwy hosta | Rozstrzygająca dla znanych robotów | Działa tylko dla zadeklarowanych botów |
| Analiza behawioralna | Czas żądań, wzorce nawigacji | Trudna do sfałszowania na dużą skalę | Wymaga danych sesji |
| Odciski palców urządzeń | Atrybuty przeglądarki i sprzętu | Silny sygnał oszustwa | Mogą mieć zastosowanie przepisy o prywatności |
| Wyzwania JavaScript | Zdolność do wykonywania skryptów | Blokuje proste skrypty | Uzasadnione roboty mogą nie uruchamiać JS |
| Pułapki typu honeypot | Ukryte linki, które śledzą tylko boty | Wykrywanie botów z wysoką pewnością | Wymaga instrumentacji strony |
Programy afiliacyjne płacą partnerom za wyniki — kliknięcia, leady lub sprzedaż. Każde oszukańcze zdarzenie liczone jako uzasadnione kosztuje prawdziwe pieniądze. Wykrywanie pająków jest pierwszą linią obrony przed kilkoma kategoriami oszustw afiliacyjnych.
Oszustwa kliknięć to najbardziej bezpośredni atak na budżety afiliacyjne. Bot symuluje kliknięcia w linki afiliacyjne, zawyżając metryki kliknięć bez żadnego ludzkiego zaangażowania. Afiliant otrzymuje wynagrodzenie za ruch, który nigdy nie miał szansy na konwersję.
Wykrywanie pająków wychwytuje oszustwa kliknięć poprzez identyfikację zautomatyzowanych wzorców stojących za kliknięciami: adresy IP centrów danych, powtarzające się kliknięcia z identycznych odcisków palców urządzeń oraz prędkości kliknięć, których żaden człowiek nie byłby w stanie wygenerować.
W programach afiliacyjnych opartych na koszcie za lead (CPL) boty wysyłają fałszywe formularze rejestracyjne, aby uruchomić wypłatę prowizji. Te leady na pierwszy rzut oka wyglądają realnie — mają nazwiska, adresy e-mail i numery telefonów — ale nigdy nie konwertują dalej.
Wykrywanie pająków oznaczają fałszywe leady poprzez sprawdzenie, czy zgłoszenie pochodzi z adresu IP centrum danych, sfałszowanego urządzenia lub domeny e-mail jednorazowego użytku — sygnałów, które rzadko pochodzą od prawdziwych użytkowników.
Cookie stuffing to bardziej podstępna forma oszustwa. Skrypt umieszcza pliki cookie śledzące afiliacji w przeglądarce użytkownika bez jego wiedzy — często poprzez pop-under, obrazek 1×1 piksel lub skrypt wstrzyknięty na zagrożoną stronę. Gdy użytkownik później dokona zakupu, oszust zgłasza roszczenie do prowizji.
Wykrywanie pająków identyfikuje zautomatyzowane skrypty wykonujące cookie stuffing po ich behawioralnej sygnaturze: szybkie, niewidoczne żądania, które ustawiają pliki cookie bez odpowiadającej im wizyty na stronie lub interakcji użytkownika.
Poza bezpośrednimi stratami finansowymi, ruch botów zanieczyszcza każdą metrykę, na której polegasz. Współczynniki konwersji spadają, ponieważ ruch botów zawyża mianownik. Wydajność kampanii staje się nieczytelna. Zespoły marketingowe optymalizują pod kątem kohort, które nigdy nie istniały.
Czyste wykrywanie pająków przywraca zaufanie do danych. Gdy odfiltrujesz ruch botów, zanim trafi do analityki, widzisz, co naprawdę robią Twoi ludzcy użytkownicy — i możesz podejmować decyzje oparte na rzeczywistości.
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
IAB Tech Lab (Interactive Advertising Bureau) utrzymuje standardowy w branży punkt odniesienia do wykrywania pająków: IAB/ABC International Spiders and Bots List. To podstawa, na której buduje się większość poważnych systemów zapobiegania oszustwom.
Lista składa się z dwóch regularnie aktualizowanych plików tekstowych:
IAB zaleca dwuetapowe podejście zdefiniowane w swoich wytycznych dotyczących pomiaru wyświetleń reklam:
Ta dwuetapowa metoda jest standardem dla akredytowanego przez MRC wykrywania nieprawidłowego ruchu (IVT). Zapewnia, że zadeklarowane roboty są odfiltrowywane, a nieznane boty nie prześlizgują się tylko dlatego, że nie ma ich na żadnej liście.
Dostęp wymaga podpisania umowy subskrypcji danych i jest udostępniany przez portal Tech Lab Tools Portal. Jedno konto logowania na subskrybującą firmę. Dla większości zarządców programów afiliacyjnych lista jest dostępna pośrednio — poprzez platformę wykrywania oszustw lub narzędzie analityczne, którego już używają, a które licencjonuje listę w ich imieniu.
Te wbudowane systemy automatycznie filtrują ruch botów z raportów, więc kliknięcia i konwersje przypisane znanym robotom indeksującym nigdy nie trafiają do obliczeń prowizji.
Zaletą wykrywania na poziomie platformy jest to, że nie wymaga konfiguracji — działa od razu, utrzymywane przez dostawcę, z zintegrowaną listą IAB.
Dla programów o wyższej ekspozycji na oszustwa — dużych wypłat CPA, wysokiego wolumenu ruchu lub branż będących celem grup przestępczych — dedykowane platformy zapobiegania oszustwom dodają warstwy wykraczające poza podstawowe wykrywanie pająków:
Nawet bez dedykowanej platformy zarządcy programów mogą ręcznie monitorować kilka sygnałów:
Pułapka na pająki to zestaw dynamicznie generowanych stron, które tworzą nieskończoną pętlę dla robotów indeksujących. Typowe przykłady obejmują:
Uzasadniony robot indeksujący napotykający pułapkę na pająki może spalić swój budżet indeksowania — liczbę stron, które przydziela Twojej witrynie — indeksując tysiące prawie zduplikowanych stron, podczas gdy prawdziwe treści pozostają nieodkryte.
Pułapki na pająki szkodzą Twojej witrynie na dwa sposoby. Po pierwsze, marnują budżet indeksowania: Googlebot przeznacza swój limit na bezsensowne adresy URL zamiast na Twoje strony produktów i wpisy na blogu. Po drugie, mogą obniżyć wydajność serwera, gdy roboty indeksujące bombardują dynamicznie generowane strony.
Rozwiązanie jest proste: użyj robots.txt, aby zabronić indeksowania wzorców URL podatnych na pułapki, dodaj tagi rel="canonical" w celu konsolidacji zduplikowanych stron i unikaj udostępniania nieskończonych przestrzeni URL poprzez linkowanie wewnętrzne. Systemy wykrywania pająków mogą również zidentyfikować, gdy znany robot indeksujący utknął w pułapce, i odpowiednio ograniczyć jego dostęp.
Zabezpiecz swoje kampanie afiliacyjne i integralność danych dzięki zaawansowanym narzędziom do wykrywania pająków i strategiom zapobiegania oszustwom.
Pająk wyszukiwarki to zautomatyzowany bot, który przeszukuje strony internetowe w celu indeksowania treści dla wyszukiwarek takich jak Google i Bing. Dowiedz si...
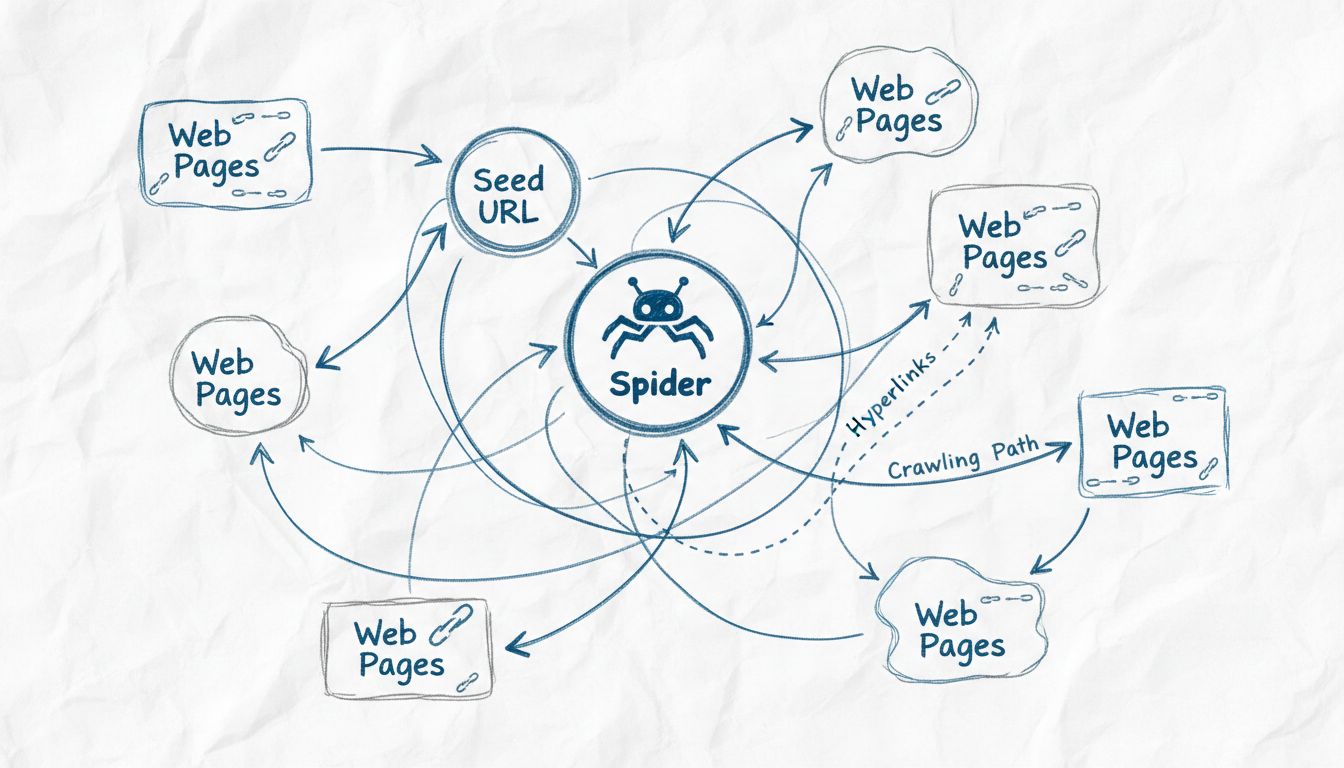
Dowiedz się, dlaczego crawlery internetowe nazywane są pająkami, jak działają i jaką kluczową rolę odgrywają w indeksowaniu przez wyszukiwarki. Poznaj mechanizm...
Dowiedz się, jak roboty indeksujące wyszukiwarki odkrywają i indeksują strony internetowe oraz dlaczego ma to znaczenie dla SEO.
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.


Zgoda na Pliki Cookie
Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our politykę prywatności.