


Pająk wyszukiwarki internetowej
Pająk wyszukiwarki to zautomatyzowany bot, który przeszukuje strony internetowe w celu indeksowania treści dla wyszukiwarek takich jak Google i Bing. Dowiedz si...
10 min czytania
SEO
DigitalMarketing
+3
Robot indeksujący wyszukiwarki to zautomatyzowany program — nazywany również botem, pająkiem lub spiderbotem — który systematycznie przegląda strony World Wide Web, pobiera ich treść i podąża za hiperłączami, aby odkrywać nowe lub zaktualizowane adresy URL.
Robot indeksujący wyszukiwarki to zautomatyzowany program — nazywany również botem, pająkiem lub spiderbotem — który systematycznie przegląda strony World Wide Web, pobiera ich treść i podąża za hiperłączami, aby odkrywać nowe lub zaktualizowane adresy URL. Jego głównym zadaniem jest dostarczanie do indeksu wyszukiwarki świeżych danych, aby gdy ktoś wpisze zapytanie, wyszukiwarka mogła zwrócić trafne i aktualne wyniki. Bez robotów indeksujących wyszukiwarka nie ma możliwości dowiedzenia się, że dana strona w ogóle istnieje.
Sam robot indeksujący nie zajmuje się rankingowaniem. Odkrywa strony i przekazuje to, co znajdzie — tekst, linki, metadane, obrazy — do osobnego systemu indeksowania i rankingu. Indeksowanie (crawling), indeksacja (indexing) i ranking to trzy odrębne etapy. Strona może zostać odwiedzona przez robota, a mimo to nigdy nie pojawić się w wynikach wyszukiwania, jeśli nie spełni progów jakościowych wyszukiwarki podczas indeksacji.
Dokumentacja Google na temat robotów indeksujących rozróżnia typowe roboty, roboty specjalistyczne oraz narzędzia wywoływane przez użytkownika. Sprawdź udokumentowaną tożsamość i zachowanie odpowiedniego robota podczas badania problemów z dostępem.
Na tej stronie
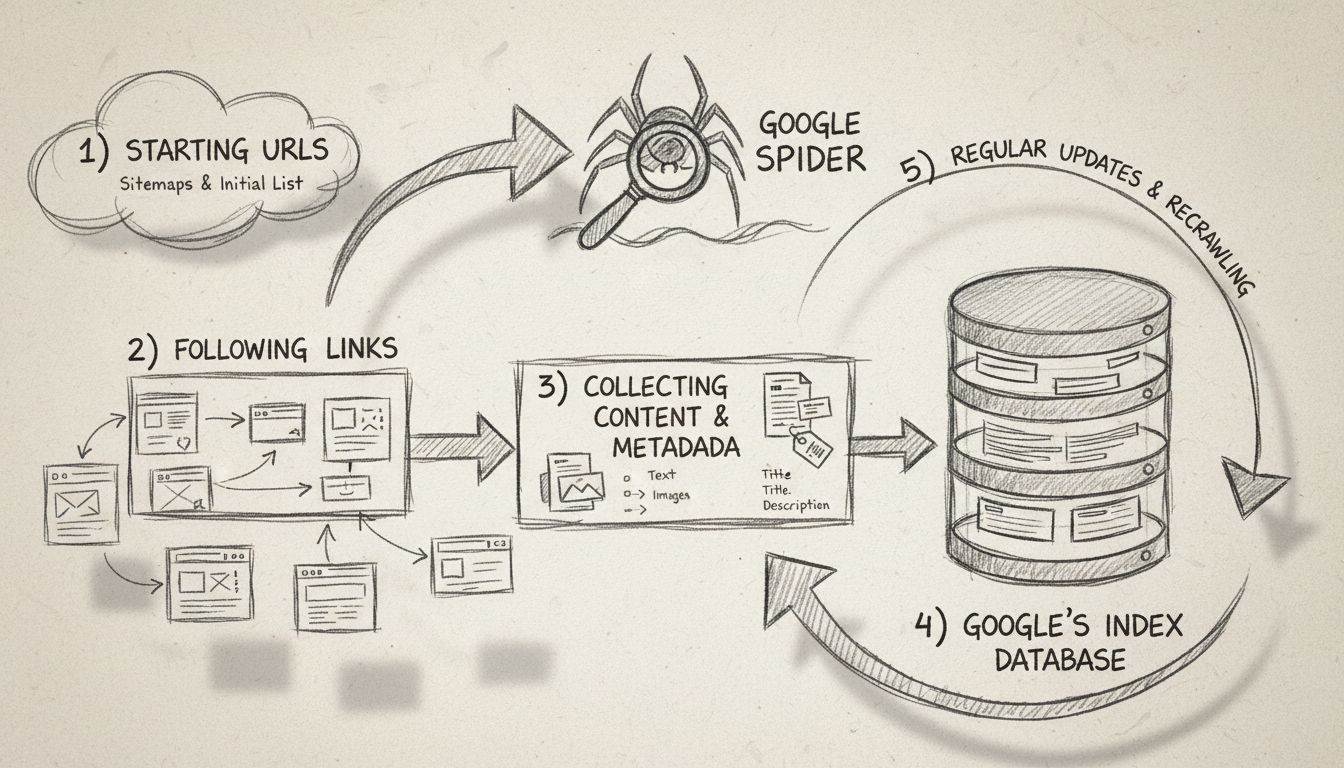
Robot indeksujący działa w ciągłej pętli opartej na kilku podstawowych krokach. Zrozumienie tych kroków pomaga właścicielom stron diagnozować, dlaczego strony mogą nie pojawiać się w wynikach wyszukiwania — problem często leży na etapie indeksowania, na długo przed tym, zanim w ogóle weźmie się pod uwagę rankingowanie.
Każdy robot zaczyna od zestawu znanych adresów URL, zwanych początkowymi adresami URL (seed URLs). Mogą one pochodzić z wcześniej zaindeksowanych stron, przesłanych map witryn lub ręcznie wybranych punktów startowych. Robot pobiera każdą początkową stronę, wyodrębnia wszystkie znalezione hiperłącza i dodaje każde nowe łącze do kolejki zwanej granicą indeksowania (crawl frontier).
Cykl następnie się powtarza:
Ta pętla tak naprawdę nigdy się nie kończy. Sieć stale się zmienia, a nowe strony pojawiają się co sekundę, więc robot po prostu przetwarza to, co jest następne w kolejce, odwiedzając ponownie stare strony w celu sprawdzenia zmian i dodając nowo odkryte adresy URL.
Gdy robot pobierze stronę, renderuje jej treść — odczytuje HTML, w miarę możliwości wykonuje JavaScript oraz wyodrębnia tekst, obrazy, metadane i dane strukturalne. Następnie pobiera te informacje i przekazuje je do indeksatora wyszukiwarki.
Nie każdy robot radzi sobie z JavaScriptem równie dobrze. Googlebot renderuje JavaScript i czeka na dynamicznie ładowane treści, ale roboty mniejszych wyszukiwarek mogą odczytywać tylko statyczny HTML. Dlatego strony zbudowane wyłącznie w oparciu o frameworki JavaScript po stronie klienta mogą być niewidoczne dla niektórych wyszukiwarek, chyba że zastosowano renderowanie po stronie serwera.
Roboty odkrywają nowe strony za pośrednictwem dwóch głównych kanałów:

Skonfiguruj zaawansowane śledzenie w kilka minut. Karta kredytowa nie jest wymagana.
Roboty nie traktują wszystkich stron jednakowo. Działają w oparciu o zestaw polityk indeksowania, które określają, które strony odwiedzić, w jakiej kolejności i jak często wracać.
Robot musi zdecydować, które adresy URL priorytetyzować ze swojej granicy indeksowania. Typowe sygnały obejmują:
Jak często robot wraca na stronę, zależy od tego, jak często ta strona się zmienia. Strona główna serwisu informacyjnego może być indeksowana co kilka minut. Statyczna strona „O nas" może być odwiedzana raz na kilka miesięcy. Webmasterzy mogą sygnalizować częstotliwość zmian za pomocą tagów <changefreq> w mapie witryny XML, choć wyszukiwarki traktują je jako wskazówki, a nie polecenia.
Roboty są zaprogramowane tak, aby nie przeciążać serwerów internetowych. Przestrzegają limitu szybkości indeksowania — maksymalnej liczby żądań, które wyślą do pojedynczej witryny w danym okresie. Jeśli serwer odpowiada błędami HTTP, takimi jak 500 lub 503, robot wycofuje się, aby nie pogłębiać problemu. To część tego, co sprawia, że indeksowanie na dużą skalę jest prawdziwym wyzwaniem inżynieryjnym.
Plik robots.txt to dokument tekstowy umieszczony w katalogu głównym domeny, który informuje roboty, które adresy URL mogą, a których nie mogą żądać. Jest to najważniejsze narzędzie do zarządzania dostępem robotów. Wpis w robots.txt może wyglądać tak:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/, ale zezwala na wszystko w katalogu /public/. Inne roboty sprawdzają ten sam plik i postępują zgodnie z własnymi dyrektywami User-agent. Warto zauważyć, że robots.txt to protokół dobrowolny — dobrze zaprogramowane roboty go przestrzegają, ale złośliwe boty mogą go całkowicie ignorować.Budżet indeksowania to liczba stron, które wyszukiwarka będzie indeksować w witrynie w danym okresie. Określają go dwa czynniki:
W przypadku małych witryn budżet indeksowania rzadko stanowi problem. W przypadku dużych platform e-commerce lub witryn z treściami mających miliony adresów URL zarządzanie budżetem indeksowania staje się kluczowe — marnowanie go na zduplikowane treści, parametry fasetowanej nawigacji lub strony o niskiej wartości oznacza mniej zasobów dla stron, które mają znaczenie.
Każda duża wyszukiwarka obsługuje własnego robota z odrębnym ciągiem User-Agent — identyfikatorem, który bot wysyła z każdym żądaniem HTTP, aby serwery wiedziały, który robot je odwiedza.
| Wyszukiwarka | Nazwa robota | Identyfikator User-Agent | Cel |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Indeksuje strony dla Google Search i innych usług Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Indeksuje strony dla Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Indeksuje strony dla wyników wyszukiwania DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Indeksuje strony dla Yandex Search (dominujący w Rosji) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Indeksuje strony dla Baidu Search (dominujący w Chinach) |
| Apple | Applebot | Applebot/1.0 | Indeksuje strony dla Spotlight Search i sugestii Siri |
Google obsługuje również wyspecjalizowane roboty dla różnych typów treści — Googlebot Image indeksuje obrazy, Googlebot Video obsługuje treści wideo, Googlebot News indeksuje artykuły informacyjne, a AdsBot sprawdza jakość stron docelowych dla Google Ads.
Bądź pierwszym, który dowie się o nowych funkcjach i aktualizacjach produktu.
Identyfikacja, czy odwiedzający to rzeczywiście Googlebot, wymaga czegoś więcej niż sprawdzenia ciągu User-Agent, ponieważ te ciągi mogą być sfałszowane. Aby zweryfikować robota Google:
Googlebot.googlebot.com lub google.com.Google udostępnia oficjalną dokumentację z listą swoich zakresów IP pod adresem google.com/bot.html. Każdy odwiedzający, który twierdzi, że jest Googlebotem, ale nie przejdzie tych kroków weryfikacyjnych, jest sfałszowanym botem i należy go traktować jako podejrzany.
Tak — ale z ograniczeniami. Główne wyszukiwarki obsługują dedykowane roboty dla treści nietekstowych:
VideoObject, aby zrozumieć tytuł, opis, miniaturę i czas trwania.Roboty nie mogą jednak „widzieć" obrazów tak jak człowiek ani „oglądać" filmu. Polegają wyłącznie na sygnałach tekstowych — nazwach plików, atrybutach alt, podpisach, otaczającym tekście i danych strukturalnych — aby określić trafność. Treści zablokowane za ścianą logowania, paywallem lub osadzone w złożonych odtwarzaczach JavaScript mogą nie zostać w ogóle zaindeksowane.
Te terminy są często używane zamiennie, ale opisują różne rzeczy:
| Aspekt | Robot indeksujący | Scraper |
|---|---|---|
| Cel | Odkrywanie i indeksowanie URL-i w całej sieci | Wyodrębnianie konkretnych danych z wybranych stron |
| Zakres | Szeroki — podąża za linkami wszędzie | Wąski — celuje w znane URL-e lub domeny |
| Wynik | Zasila indeks wyszukiwarki | Tworzy ustrukturyzowane dane (CSV, baza danych, arkusz kalkulacyjny) |
| Typowy operator | Wyszukiwarki (Google, Bing) | Firmy, badacze, analitycy danych |
| Przestrzega robots.txt | Tak (legalne roboty) | Różnie — wiele scraperów ignoruje |
| Przykłady | Googlebot, Bingbot | Narzędzia do monitorowania cen, scrapery do generowania leadów, zbieracze danych do trenowania AI |
Wyszukiwarki znajdują nowe strony za pośrednictwem kilku kanałów:
Najszybszym sposobem na zaindeksowanie nowej strony jest przesłanie jej adresu URL bezpośrednio przez Search Console i upewnienie się, że prowadzi do niej link z już zaindeksowanej strony w tej samej witrynie.
Nie ma ustalonego harmonogramu. Częstotliwość ponownych odwiedzin zależy od:
Właściciele witryn mogą wpływać na częstotliwość indeksowania poprzez regularne publikowanie treści, utrzymywanie szybkiego czasu odpowiedzi serwera i przesyłanie zaktualizowanych map witryn. Ostatecznie jednak robot sam decyduje o swoim harmonogramie na podstawie obserwowanych sygnałów.
Roboty zazwyczaj nie mają dostępu do:
Robot widzi tylko to, co jest publicznie dostępne i połączone linkami. Jeśli strona wymaga uwierzytelnienia lub interakcji użytkownika, aby się wyrenderować, jest praktycznie niewidoczna dla wyszukiwarek — chyba że właściciel witryny wyraźnie przyzna dostęp lub zapewni alternatywną ścieżkę, taką jak mapa witryny zawierająca adres URL wraz z danymi strukturalnymi opisującymi treść.
Zbudowanie robota, który działa dla kilkuset stron, jest stosunkowo proste. Zbudowanie takiego, który działa dla miliardów, to zupełnie inny problem. Typowe punkty awarii obejmują:
Dla większości firm prowadzenie robota indeksującego na dużą skalę nie jest praktyczne bez zarządzanej infrastruktury. Decyzja zwykle sprowadza się do użycia istniejącego narzędzia zamiast budowania od zera.
W Stanach Zjednoczonych indeksowanie publicznie dostępnych stron jest generalnie legalne. Kilka orzeczeń sądowych — w tym hiQ Labs przeciwko LinkedIn — potwierdziło, że dostęp do publicznych danych nie narusza prawa, nawet wbrew warunkom korzystania z usługi.
Jednak legalność zależy od kilku czynników:
Rozróżnienie między indeksowaniem dla celów wyszukiwania (powszechnie akceptowane) a scrapowaniem w celu komercyjnego wydobycia danych (częściej kwestionowane prawnie) ma znaczenie. Większość legalnych robotów wyszukiwarek działa w wyraźnie legalnym obszarze.
Nie — sam ChatGPT nie jest robotem indeksującym. ChatGPT to konwersacyjny model AI, który generuje odpowiedzi. OpenAI obsługuje jednak osobnego robota indeksującego o nazwie GPTBot, który indeksuje publiczne strony internetowe w celu zbierania danych treningowych dla modeli AI oraz wspomagania funkcji wyszukiwania na żywo w niektórych produktach OpenAI.
GPTBot identyfikuje się za pomocą tokena User-Agent GPTBot i przestrzega dyrektyw robots.txt. Właściciele witryn, którzy chcą zablokować konkretnie GPTBota, mogą dodać następujący wpis do swojego pliku robots.txt:
User-agent: GPTBot
Disallow: /
Roboty indeksujące wyszukiwarek bezpośrednio wpływają na wszystkich uczestników ekosystemu marketingu afiliacyjnego. Jeśli strona nie jest indeksowana, nie pojawia się w wynikach wyszukiwania, a jeśli nie pojawia się w wynikach, nie generuje ruchu organicznego — ani przychodów afiliacyjnych.
Witryna wydawcy z treściami żyje lub umiera dzięki możliwości indeksowania. Każda recenzja produktu, poradnik porównawczy czy zestawienie ofert musi być możliwa do odkrycia przez roboty. Typowe błędy wydawców, które blokują indeksowanie, obejmują:
Wydawcy powinni sprawdzić, czy ich najcenniejsze strony pojawiają się w raporcie pokrycia indeksu Google Search Console i czy żadne tagi noindex ani reguły robots.txt nie blokują ich nieumyślnie.
Reklamodawca prowadzący program afiliacyjny potrzebuje, aby jego strony produktowe były indeksowane, aby wydawcy mogli linkować do aktywnych, widocznych stron. Jeśli strony produktowe sprzedawcy nie znajdują się w indeksie Google, wydawcy nie mają gdzie kierować ruchu. Konkretne zagrożenia obejmują:
Sprzedawcy powinni utrzymywać czystą strukturę URL, przesyłać mapy witryn produktów i monitorować statystyki indeksowania w Search Console, aby wychwytywać problemy, zanim wpłyną one na partnerów wydawców.
Menedżerowie programów znajdują się między sprzedawcami a wydawcami i powinni rozumieć zachowanie robotów, aby rozwiązywać problemy z widocznością. Gdy wydawca zgłasza, że strona produktowa sprzedawcy „nie pojawia się w Google", problem często dotyczy indeksowania — a nie rankingu. Praktyczne kroki obejmują:
site: Google.Menedżer programu, który potrafi diagnozować podstawowe problemy z indeksowaniem, dodaje bezpośrednią wartość obu stronom relacji afiliacyjnej — pomagając sprzedawcom naprawiać problemy techniczne i pomagając wydawcom potwierdzać, że promowane przez nich strony są dostępne dla wyszukiwarek.
Dowiedz się, jak zrozumienie robotów indeksujących i optymalizacja pod ich kątem może zwiększyć widoczność Twojej witryny i pozycję w wynikach wyszukiwania.
Pająk wyszukiwarki to zautomatyzowany bot, który przeszukuje strony internetowe w celu indeksowania treści dla wyszukiwarek takich jak Google i Bing. Dowiedz si...
Dowiedz się, czym jest Google Spider (Googlebot), jak przeszukuje i indeksuje strony internetowe oraz dlaczego jest kluczowy dla SEO. Odkryj, jak zoptymalizować...
Wykrywanie pająków identyfikuje zautomatyzowane boty przeszukujące strony internetowe, aby zapobiegać oszustwom kliknięć, fałszywym leadom i zniekształconym ana...
Dołącz do naszej społeczności zadowolonych klientów i zapewnij doskonałą obsługę klienta dzięki PostAffiliatePro.


Zgoda na Pliki Cookie
Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our privacy policy.